目标从哪里来:为什么 AI 需要规范建模
损失函数只是决策问题四个部分中的一个。本文从 Wald 的决策理论讲到规范建模,讨论目标从哪里来,以及为什么现代 AI 需要把目标当作有待检验的假说。
[写于 2026 年 5 月,2026 年 11 月修改。]
大多数深度学习论文都有一个损失函数(loss function)。通常的做法是:选定一种损失函数,加上正则项,调节各项之间的权重超参数,再报告训练中损失降了多少。但有一件事很少有人关注:这个损失函数从哪里来,它在一个更大的问题里处于什么位置。
1939 年,Abraham Wald 把统计学写成一个由四部分组成的决策问题:
- 一个生成观测的世界;
- 一组可选的行动;
- 每个行动在每种可能的世界下的损失;
- 世界未知时汇总风险的规则。
损失函数是其中的第三点。
深度学习自动化的,是压低损失这一步:给定损失函数,梯度下降会调整数百万到数十亿个参数把它压低,全程几乎不需要人参与。其余三点在训练开始前就由我们设定好:数据从哪里来,系统可以做什么,风险怎样平均。损失函数本身的形式也由我们决定。这样的设置取得了惊人的成效。
研究知觉与动作的学科(如心理物理学和运动控制)解释行为时,会把四个部分都明确写出来:智能体接收的信息从哪里来,它能做哪些动作,它在意什么,世界未知时它怎样权衡风险。其中第三点,也就是损失,被当作一个有待检验的假说:它猜的是每种结果对智能体来说有多糟。比如一个人伸手去够目标,偏差大一倍,代价是大一倍还是大四倍?这个假说只针对损失的形式:智能体内部不必真的算出这个函数,只要求它的行为看起来像在压低这个损失。
要检验这个假说,先推导出智能体在这个损失和它所受的约束下应该怎样行动,这就是预测;再改变犯错的代价或噪声的大小,看实际行为是否按预测的方向变化。这种方法叫作规范建模(normative modeling)。被研究的智能体过去主要是动物和人,也可以是人工智能系统。
我认为,规范建模这套方法应该在现代 AI 中大规模落地。我们的系统越来越难从内部解释,也开始塑造自己的目标。与此同时,它们是第一类目标、数据和架构几乎完全由我们掌握的智能体,因此非常适合用规范建模来研究。
全文分五个部分:
- 第一部分,损失从哪里来。 Wald 的决策理论,以及二战时期的两个有趣例子。
- 第二部分,为什么损失函数看起来就是建模的全部?(它不是!) 现代 AI 系统究竟自动化了什么,又把什么固定成了默认设置,这种设置的代价是什么。
- 第三部分,规范建模。 把损失本身当作假说,并区分理想系统、受限系统与实际系统。
- 第四部分,为什么应该在现代 AI 中落地。 全都可及为什么仍不等于理解,AI 比大脑更可及在哪里,已有的工作,以及一个完整的例子。
- 第五部分,会演化的目标。 有层次的学习回路,好的演化与坏的演化,以及目标何时应当改变。
熟悉决策理论的读者可以直接跳到第二部分。在神经科学里接触过规范建模的读者,不妨从第四部分读起。
记号。
| 符号 | 含义 |
|---|---|
| $\theta \in \Theta$ | 世界的状态:一个参数、一个标签或一个隐藏原因 |
| $x \sim p(x \mid \theta)$ | 由世界生成的观测 |
| $p(\theta)$ | 世界状态的先验 |
| $a \in \mathcal{A}$ | 行动,即决策 |
| $\delta: x \mapsto a$ | 决策规则;作为策略时记作 $\pi$ |
| $L(\theta, a)$ | 世界为 $\theta$ 时采取行动 $a$ 的损失 |
| $R(\theta, \delta)$ | 风险:规则 $\delta$ 在世界 $\theta$ 中的期望损失 |
| $\Pi$, $\Pi_C$ | 全部规则,以及约束 $C$ 下允许的规则 |
第一部分 · 损失从哪里来
说到损失函数从哪里来,教科书上常见的是一张清单:回归用平方误差,分类用交叉熵,检索用间隔(margin)。然而在更早的时候,对这个问题的回答是一整套决策理论。这套理论把统计方法看作依据数据做决定的规则。既然是做决定,就要衡量每个决定在每种实际情况下的后果有多糟,损失就是这个衡量;它取什么形式,取决于这个决定是为了什么。
1.1 · Wald 1939:作为决策的统计学
到 1930 年代末,统计学有两套成熟但彼此独立的理论:估计理论和假设检验。估计理论研究怎样从数据推算一个未知的量,比如由多次天文观测推算行星的轨道。它承袭 Gauss 和 Fisher 的传统,衡量一个估计好不好,看的是它离真值有多近。假设检验研究怎样在几种说法之间做出选择,比如判断一种新药是否比安慰剂有效。它采用 Neyman 和 Pearson[1] 在 1933 年给出的形式:在把第一类错误率控制在给定水平的前提下,让第二类错误率尽可能低。两套理论对“什么样的程序才算好”各有各的标准。
Abraham Wald 是一位数学家,1938 年从维也纳来到美国。他认为这两套理论讲的是同一个问题。在 “Contributions to the Theory of Statistical Estimation and Testing Hypotheses”[2] 一文中,他把每一种统计程序都看作依据数据采取行动的规则:你观察到一些东西,做出某个决定,而这个决定的后果取决于实际情况究竟如何。
把这个问题写出来,它有四个部分:
- 世界与观测。 一个未知状态 $\theta \in \Theta$ 生成数据,$x \sim p(x \mid \theta)$。
- 行动。 看到 $x$ 之后,你通过一条决策规则选择行动,$a = \delta(x)$。
- 损失。 每一对世界与行动都对应一个代价 $L(\theta, a)$。Wald 称之为权重函数(weight function,指每种错误该占多大分量,与神经网络的权重无关);“损失”这个名称是后来才有的。
- 风险准则。 在固定的世界中,一条规则的好坏用它的期望损失来衡量,
$$R(\theta,\delta) \;=\; \mathbb{E}_{x \sim p(x \mid \theta)}\big[\,L(\theta,\delta(x))\,\big],$$
其中,不同的 $\theta$ 代表不同的可能世界。$\theta$ 未知时,问哪条规则最好,就是要它在所有可能的世界里都表现得足够好。每个世界下的风险是算得出来的:观测模型、损失和规则一旦确定,风险也就确定了,这一步不涉及任何选择。“足够好”怎么衡量,则要把各个世界下的风险汇总成一个数:是按先验加权平均,还是只看最坏的情况?选损失是一项决定,选汇总方式是另一项决定。
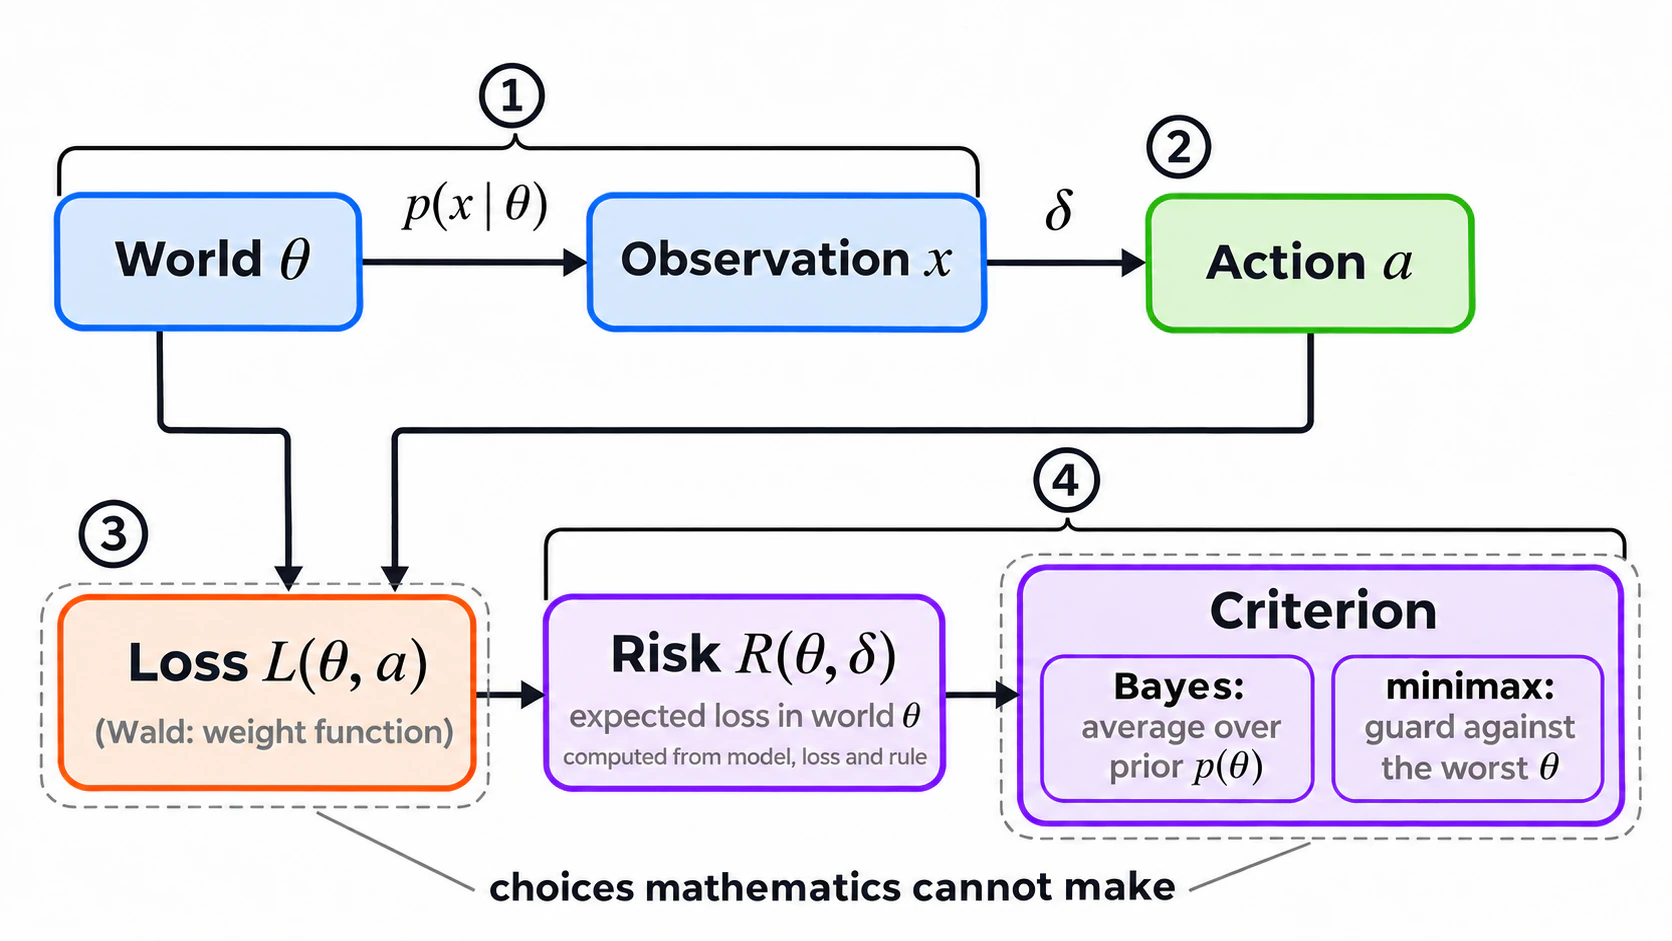
有了这个框架,估计和检验就都成了统计决策问题的特例:
- 估计。 行动是对 $\theta$ 的一个猜测 $a$,损失衡量这个猜测离真值有多远,平方误差 $L(\theta, a) = (\theta - a)^2$ 就是一例。
- 检验。 行动只有两个:接受或拒绝原假设。损失给每一种结果规定一个代价:判断正确,代价为零;犯第一类错误或第二类错误,各付出相应的代价。
两个问题的结构完全相同,不同的只是可以采取的行动,以及衡量后果的损失。
风险准则这一部分,体现了统计决策理论本身的局限。由于风险是 $\theta$ 的函数,一般来说,没有哪条规则能在每个世界 $\theta$ 里风险都最低。比如一条永远回答 $\theta = 0$ 的规则:在 $\theta$ 真的为零时,它的损失为零,没有规则能胜过它;$\theta$ 离零越远,它就越差。因此,要给规则排序,就得选定汇总的方式。有两种选择成了标准,即贝叶斯准则和极小化极大(minimax)准则:
$$\delta_{\text{Bayes}} \;=\; \arg\min_{\delta} \int R(\theta,\delta)\,p(\theta)\,d\theta, \qquad \delta_{\text{minimax}} \;=\; \arg\min_{\delta}\, \sup_{\theta}\, R(\theta,\delta).$$
贝叶斯规则在先验下对风险取平均;极小化极大规则防范最坏的世界。Wald 偏向 minimax,并在 1945 年明确指出了它与 von Neumann 博弈论的联系:统计学是一场与自然对弈的零和博弈[3]。
世界由事实决定,要靠观察和建模去刻画。决策规则是求解的对象:世界、损失和汇总方式一旦确定,最优规则在理论上也就确定了,剩下的工作属于数学,包括证明它存在、把它算出来,或者在候选规则中把它找出来。损失和风险准则要由人来选定,数学替你做不了这个决定。关于损失,Wald 在 1939 年就说过:权重函数的形式该怎样定,“不是一个数学或统计问题”,统计学家必须先定下各种错误的相对重要性,而这完全取决于研究的特定目的。汇总方式也一样:用先验还是看最坏情况,取决于你对各个可能的世界有多少把握,以及愿意承担多大的风险。Wald 后来的专著,把选定这两项之后的那部分数学建成了一个完整的理论[4]。
请记住这两项选择。本文很大一部分讲的就是它们后来的遭遇。
1.2 · 二战时期的两个统计决策问题
1942 年到 1945 年,Wald 在哥伦比亚大学的统计研究组(Statistical Research Group)工作,这个组是为美国军方解答问题的统计学家团队。他在那几年有两项重要的成果。第一项回答的问题是:当数据要逐个收集、每多收集一个都要付出代价时,什么时候应该停止收集证据、做出决定?这个问题后来发展成序贯决策理论,一路通向动态规划和今天的强化学习;在神经科学里,它成了解释人和动物怎样做选择的证据累积模型。第二项回到对世界的观测本身:你看到的数据,是否已经被获取它的方式筛选过一遍?这个问题今天常以“幸存者偏差”之名被人提起;在机器学习里,它就是训练数据的选择偏差。
1.2.1 · 何时停止观察
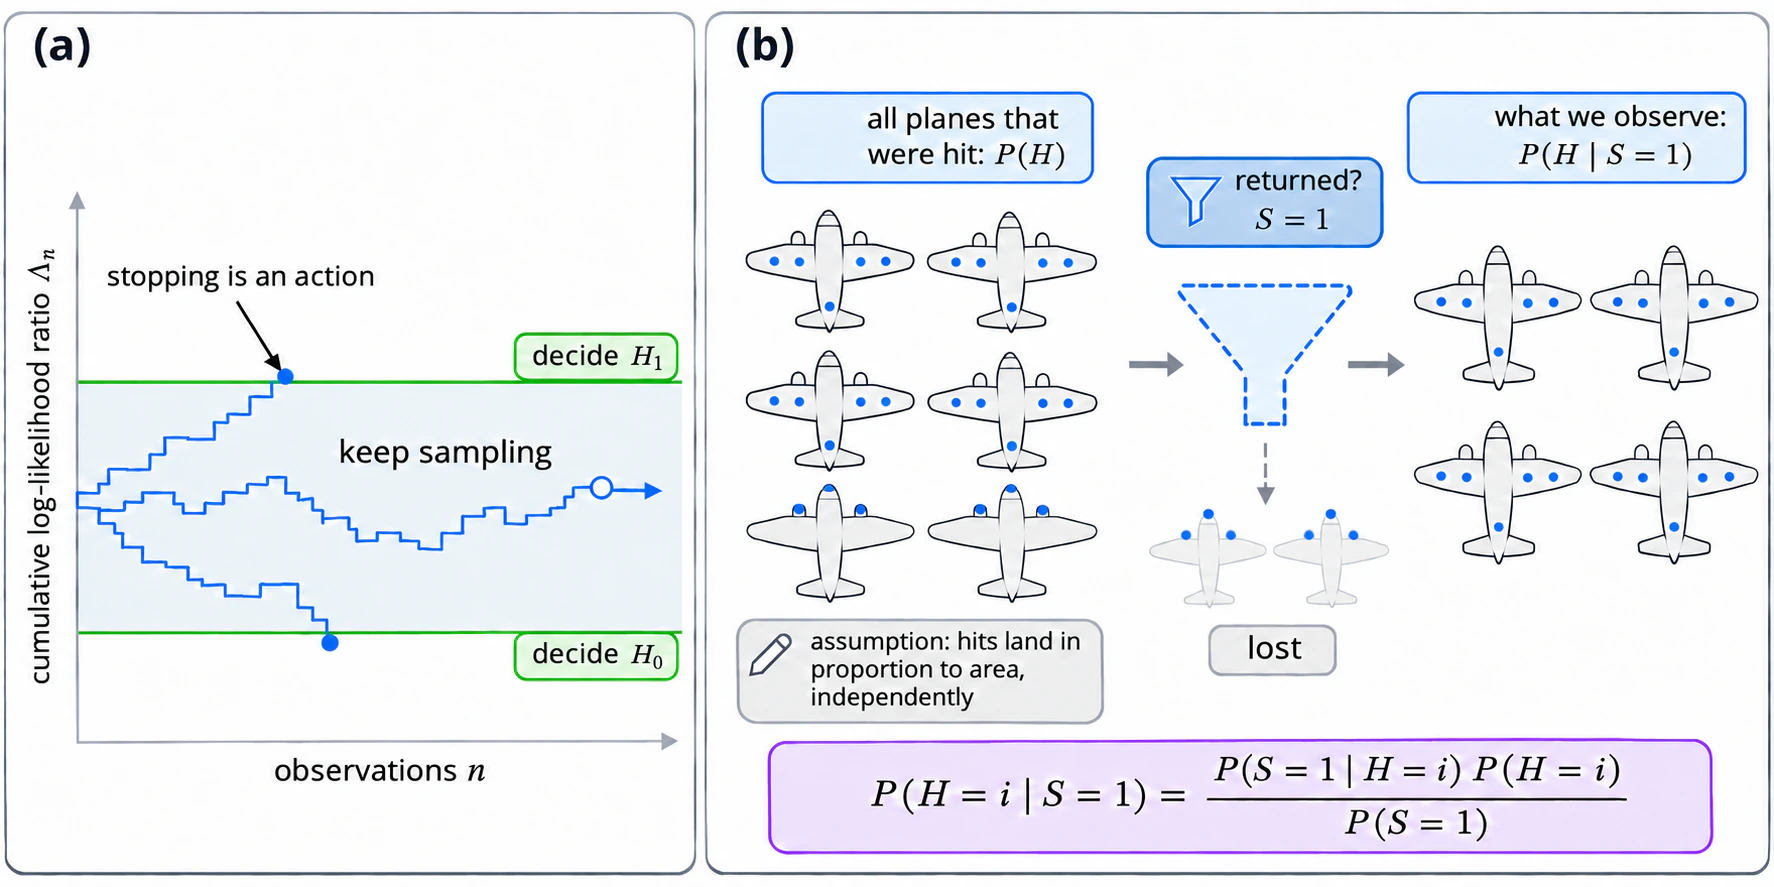
第一个问题来自军需品检验,每做一次检验都要耗费时间和物资。Wald 的答案是序贯概率比检验(sequential probability ratio test,SPRT)[5, 6]。每得到一个观测,就把它的对数似然比加到累计和上,
$$\Lambda_n \;=\; \sum_{i=1}^{n} \log \frac{p(x_i \mid H_1)}{p(x_i \mid H_0)},$$
一旦累计和越过上边界(判定 $H_1$)或下边界(判定 $H_0$)就停止;在两条边界之间,就再取一个观测。Wald 和 Wolfowitz(1948)[7]证明,在错误率相同的所有检验中,SPRT 平均所需的观测次数最少。
SPRT 把“停止”变成了一个有代价的行动。决策问题因此多了一条时间轴:每一步你都可以立即行动,也可以付出代价再多看一些。Arrow、Blackwell 和 Girshick(1949)[8]从最后一步倒推,解决了这类问题的一般形式,那时离 Bellman 把这种方法命名为动态规划还有几年。在适当的扩散近似下,对数似然比的累积会成为一个漂移扩散过程。这把 SPRT 和后来的人类选择模型联系了起来(1.3 节)。
1.2.2 · 数据从哪里来
这个问题的流行版本人人都听过:二战时,军方统计返航轰炸机上的弹孔,发现机翼和机身上弹孔多,打算在这些地方加装甲;Wald 力排众议,说该加固的是弹孔少的地方,比如引擎,因为引擎中弹的飞机都没能飞回来。
这个故事的证据很单薄[9],而且它讲的和 Wald 实际研究的是两个不同的问题。在哪里加装甲是一个决策问题:要回答它,得先有一个损失和一笔预算,比如损失一架飞机的代价有多大,又有多少装甲可用。
Wald 实际写的是一份技术备忘录,题为 “A Method of Estimating Plane Vulnerability Based on Damage of Survivors”[10]。军方想知道,轰炸机某个部位中弹后被击落的可能性有多大,而手上唯一的数据是返航飞机上的弹孔。
设 $H$ 为中弹部位,$S = 1$ 表示飞机幸存。贝叶斯公式把观测到的量和想求的量联系起来:
$$P(H=i \mid S=1) \;=\; \frac{P(S=1 \mid H=i)\,P(H=i)}{P(S=1)}.$$
左边是返航飞机上的弹孔分布。真正关心的量 $P(S=0 \mid H=i)$ 藏在右边。要把它求出来,需要幸存飞机提供不了的信息:所有飞机(包括没能返航的)中弹的位置,以及损失了多少架。Wald 用一个假设补上了这部分信息:命中位置大致与面积成正比,且彼此独立。有了这个假设,返航飞机上弹孔稀少的部位,就成了该部位中弹致命的证据。没有这个假设,“引擎上弹孔少”和“敌人很少打中引擎”就无从区分。
这比传说更精彩:备忘录论证了从经过筛选的数据中能识别出什么,以及这需要哪些样本之外的知识[11]。
Wald 的估计和加装甲的决定,也对应两种容易混淆的失败。估计出错,是对世界的推断错了,原因常常是过滤器藏起了一部分信息,补救要靠弄清筛选是怎么发生的;装甲放错,是在这个世界里行动错了,问题常常出在罕见但代价高昂的情况上,补救要靠选对损失。
1.2.3 · 两个问题合起来看
这两个问题拓展的是 1939 年框架中的不同部分。SPRT 把时间放进了行动:停止本身成了一项决策。这条线后来通向序贯决策、动态规划和强化学习,也通向神经科学里的证据累积模型(1.3 节)。易损性备忘录把筛选机制放进了世界与观测:数据集是经过一道过滤之后的世界。这正是今天机器学习里的选择偏差问题,第二部分会看到它在奖励模型的训练数据里再次出现。
这两个问题在现代 AI 中结合了起来:智能体要自己决定尝试哪些动作、试到什么时候为止(SPRT 的问题);它只看得到自己试过的动作带来的结果,手里的数据是被自己的策略筛选过的(易损性备忘录的问题)。就像 Wald 需要一个关于命中分布的假设一样,在机器学习中,要校正这种偏差,就得为筛选是如何发生的建立模型。
1.3 · 决策框架的开枝散叶
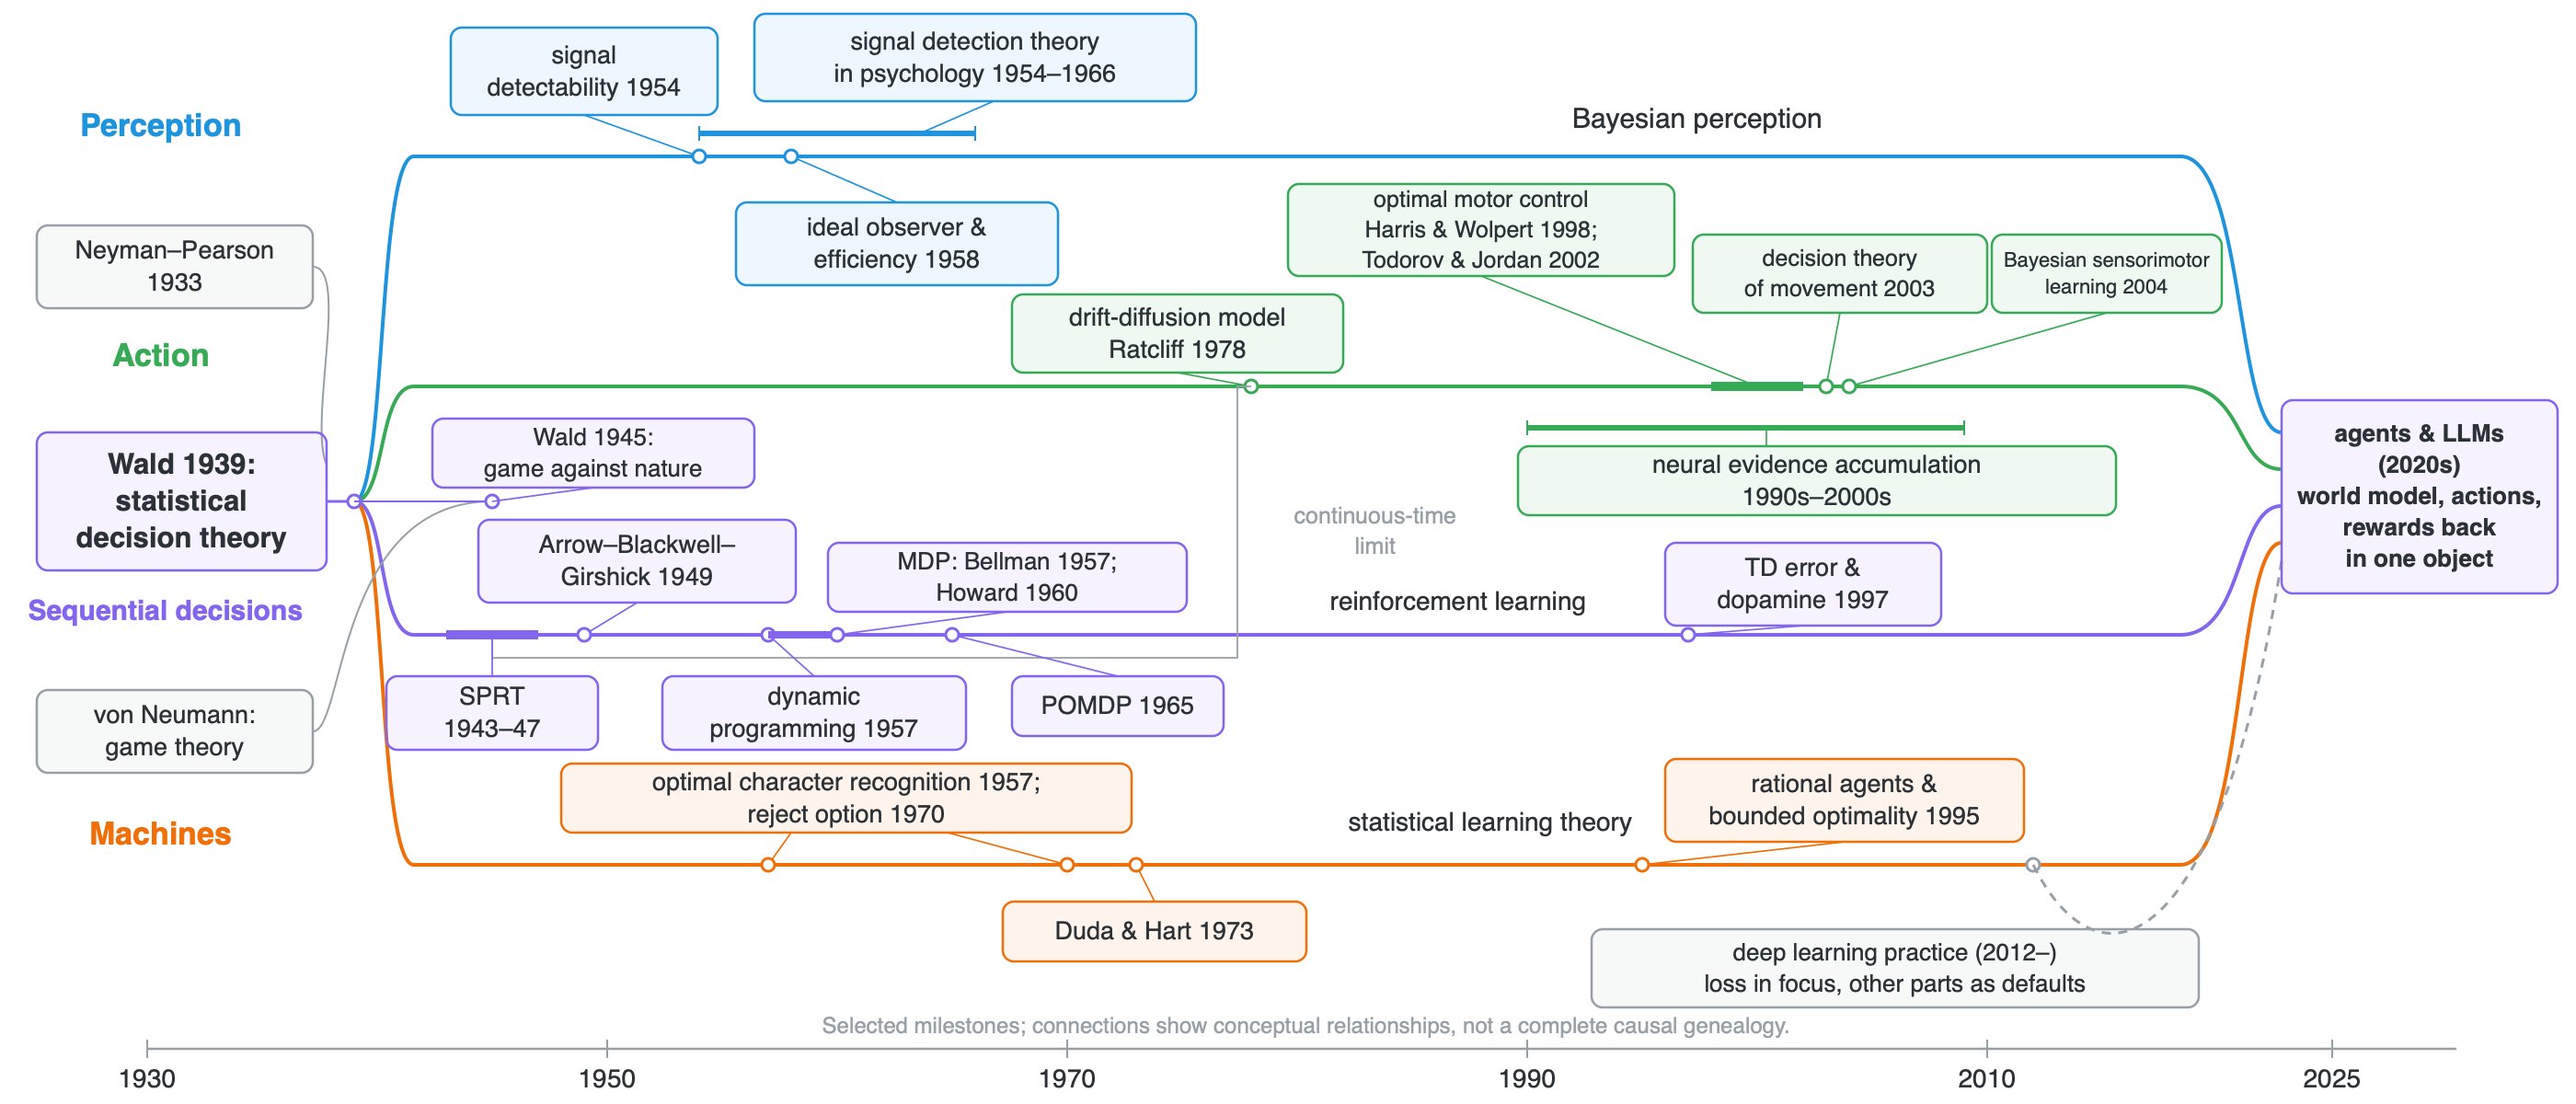
战后,Wald 的框架传到了许多领域,并在其中扎下根来。这里讲其中四个:知觉、动作、序贯决策,以及机器学习与 AI。在这些领域里,决策问题的四个部分都写得清清楚楚;它们在后文也都会再次出现。
知觉。 Peterson、Birdsall 和 Fox(1954)[12]以似然比为基础,建立了信号可检测性理论;Tanner 和 Swets(1954)[13]把它作为“视觉检测的决策理论”(a decision-making theory of visual detection)引入心理学;Green 和 Swets(1966)[14]让信号检测论成为标准工具。
信号检测论的关键一步,是把旧的阈限理论混在一起的两件事分开:一是证据本身有多强,二是依据证据怎样做决定。观察者在每次试验中得到一份内部证据,有信号和没有信号时,这份证据服从不同的分布;两个分布分得越开,证据就越强,这用敏感度 $d'$ 来衡量。要回答“有”还是“没有”,最优的做法是把证据和一个判断标准相比,而标准的位置由先验和各类错误的代价决定:虚报的代价越高,标准就越往上移,观察者越不轻易说“有”。于是,改变奖惩会移动判断标准,敏感度却保持不变,实验可以把这两者分开测量(图 3)。
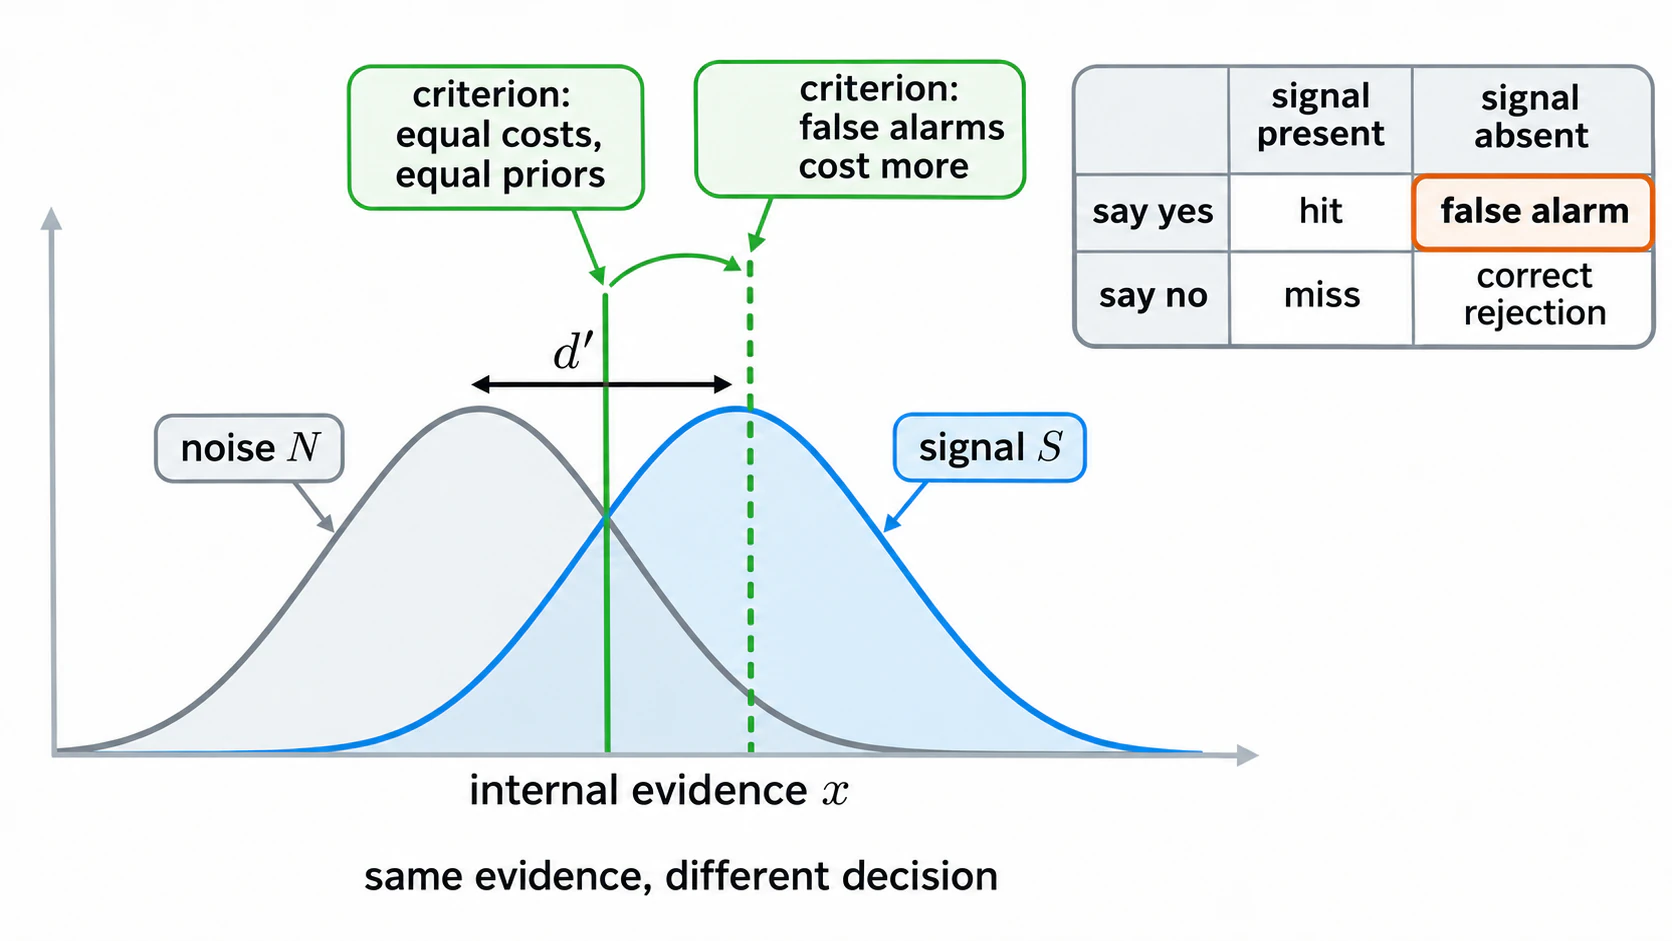
信号检测论还为知觉研究提供了基准。理想观察者(ideal observer)把刺激的生成模型、任务、损失和最优推断结合在一起,它告诉我们:凭现有信息,这项任务最多能做到多好。拿人和它比较,就得到效率 $\eta = (d'_{\text{human}} / d'_{\text{ideal}})^2$ [15]。真实观察者与理想之间的差距,成了需要解释的对象。第三部分正是沿着这一步展开的。
动作。 用最优化解释运动的理论,在世纪之交成形。Harris 和 Wolpert(1998)[16]用随信号增大的运动噪声(signal-dependent noise)来建模运动规划;Todorov 和 Jordan(2002)[17]提出最优反馈控制,作为运动协调的理论。这些理论把任务、变异性和代价都纳入了解释。
Trommershäuser、Maloney 和 Landy(2003)[18]在快速指点运动中把统计决策问题明确地摆了出来:目标旁边有一块惩罚区域,而且输赢涉及真金白银。运动噪声让落点分散,因此最佳瞄准点要往远离惩罚区的方向偏移,偏移量可以由理论算出,而人的表现接近这个值。Körding 和 Wolpert(2004)[19]报告说,人会把先前经验与带噪声的反馈结合起来,各自按可靠程度加权。
序贯决策。 SPRT 带来的时间轴有两条去向。一条是证据累积:Ratcliff 的扩散模型(1978)[20]描述了证据如何朝某个选择累积;后来的神经研究把证据累积与猴子顶叶皮层的活动联系起来,对最优决策的分析则厘清了这个模型与序贯检验的关系[21, 22]。另一条发展成了一个独立的领域:Bellman 的动态规划(1957)[23]、Howard 的马尔可夫决策过程(1960)[24],以及 Åström 的部分可观测版本(1965)[25],把决策问题写成了一个过程。部分可观测马尔可夫决策过程(POMDP)差不多就是动起来的 Wald 框架:
$$p(s_{t+1} \mid s_t, a_t), \qquad p(o_t \mid s_t), \qquad r(s_t, a_t), \qquad \pi^{\ast} \;=\; \arg\max_{\pi}\, \mathbb{E}\Big[\sum_t \gamma^t\, r(s_t, a_t)\Big].$$
世界的动态、观测、行动及其后果都写得明明白白,智能体对隐藏状态的信念是一个后验。强化学习就是从这条线上长出来的[26]。它甚至进入了神经科学:强化学习中的时间差分误差与多巴胺神经元的放电相吻合[27],这是在大脑中找到规范算法的最干净的案例之一。
机器学习与 AI。 模式识别一开始也是在决策框架内发展起来的。Chow(1957)[28]用决策函数设计了最优的字符识别器,后来又推导出机器可以拒绝作答时的最优规则[29]:在标签集之外多加一个行动,它有自己的代价。Duda 和 Hart 的教科书(1973)[30]第二章开篇就是贝叶斯决策理论,状态、行动和损失矩阵都明明白白地写了出来。学习理论把同一结构用在了学习本身上。在 Vapnik 的框架[31]中,世界的未知状态是数据分布,观测是训练集,决策规则是学习算法,损失是总体风险。学习理论中的 minimax 下界,就是字面意义上的 Wald minimax。
AI 作为一个领域,也是这样看待自己的。Russell 和 Norvig 的教科书(1995)[32]把这个领域定义为对理性智能体(rational agent)的研究,Russell 和 Subramanian(1995)[33]进一步要求有限最优(bounded optimality):一个程序要在它所运行的机器上做到尽可能好。大约二十年后,认知科学以“资源理性分析”(resource-rational analysis)之名得出了同样的想法[34, 35]。
到深度学习登场时,完整的决策问题已经是知觉、运动控制、序贯决策以及早期机器学习与 AI 理论的标准配置。这些领域都会写清楚:世界是什么,系统能做什么,每种结果的代价是多少,以及怎样对未知的部分取平均。这四个部分在深度学习里都还在,只是分工变了。第二部分要讨论的是:哪一部分交给了梯度下降去自动完成,哪些在训练前由人设定,又渐渐固定成了默认设置。
第二部分 · 为什么损失函数看起来就是建模的全部?(它不是!)
深度学习在理论上保留了完整的决策问题,在实践中却走了样:定义和建模一个问题,几乎就等于选一个损失;其余三个部分则变得相当制式,大多沿用惯例。损失函数选定之后,降低和优化它的工作由梯度下降这类算法自动完成;而损失本身取什么形式、用什么观测数据、允许怎样的行动和策略、怎样平均风险,仍然由人来决定。能交给算法自动完成的那一部分进步飞快,由人来定的那几部分却很少被重新审视。那么,梯度下降压低损失的时候,我们实际上在优化什么呢?而那些固定下来的部分,又让我们的建模付出了什么代价呢?
2.1 · 梯度下降自动化了什么
拿一个标准的监督学习网络,与 Wald 的四个部分逐一对照:标签 $y$ 扮演世界状态,输入 $x$ 是观测;网络在标签集里给出的输出是行动;损失 $\ell(y, \hat{y})$ 衡量输出与标签之间的差距;准则是在训练集上取平均。
优化器只负责其中的损失:它调整网络参数,把平均损失压低。另外三个部分它碰不到:数据在训练前就已收集好;行动空间由事先定好的标签集决定,输出层只是按它来搭建;准则通常是对训练样本等权取平均。三者共同定义了梯度下降要解的问题,所以必须在训练开始前定下来。实践中,它们大多被当成了默认配置。
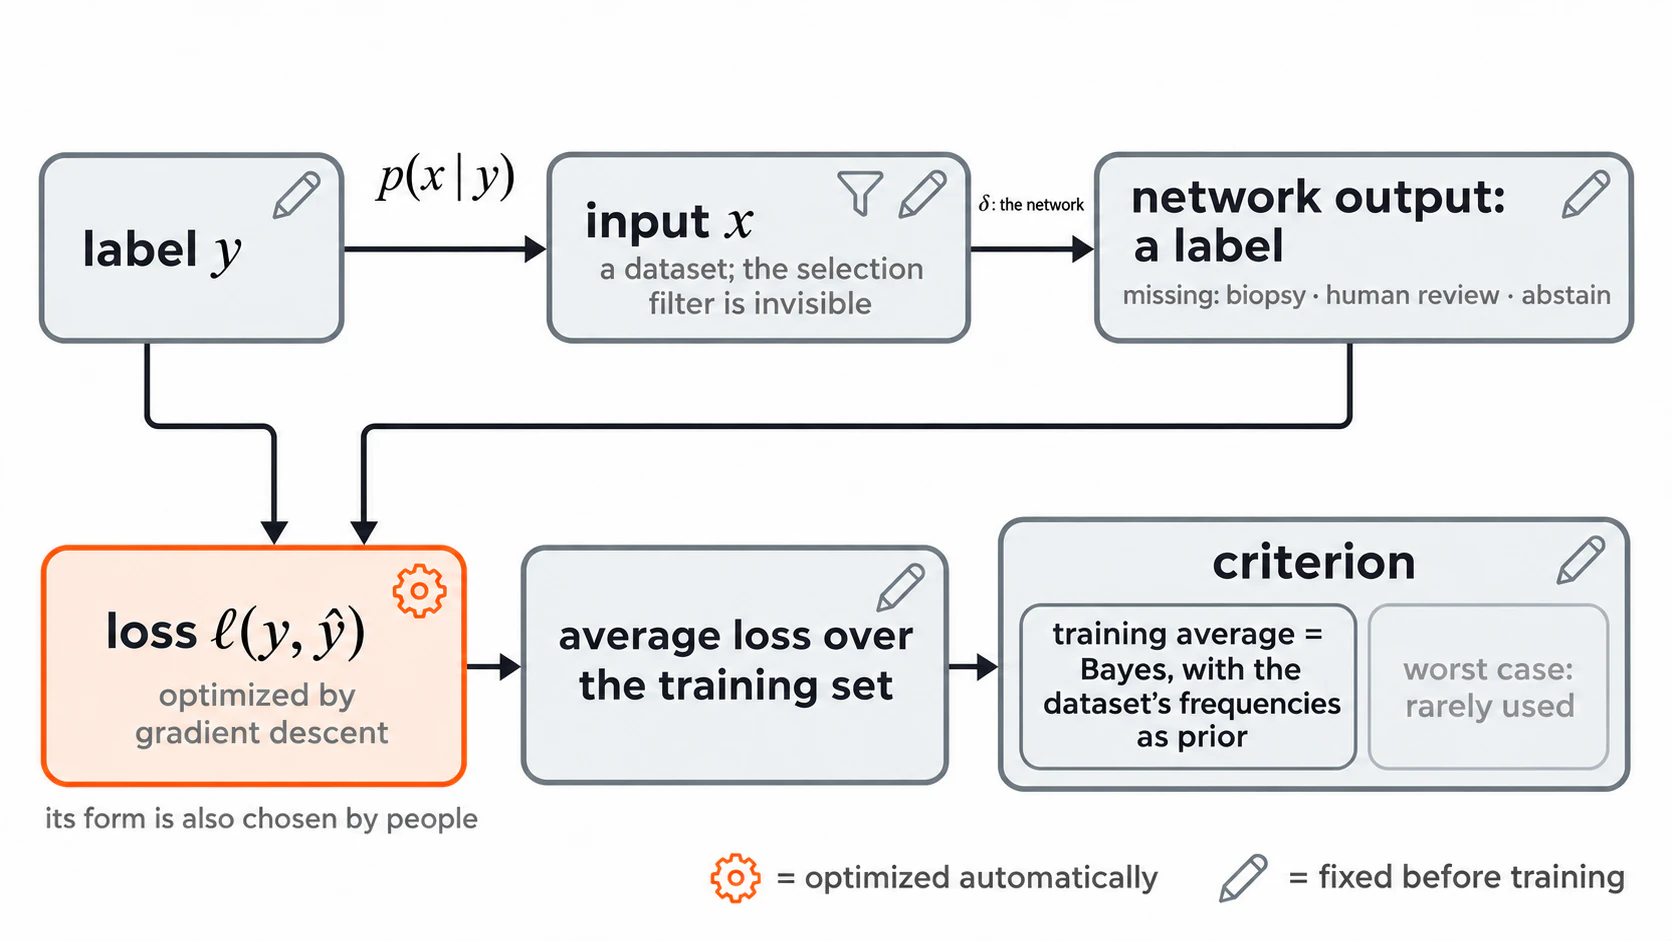
世界与观测:数据集。 每一个数据集都经过了某种过滤:照片由人按自己的审美、用手头的器材、在自己去得到的地方拍下,上传之后被搜索引擎找到,等标注者对标签达成一致才被留下。训练目标只看得到通过了过滤的部分。早在深度学习让数据集成为核心之前,这种偏差就已经是一个已知问题[36]。但我们很少在模型里明确地刻画这道过滤,大多只是把它笼统地称作“数据集偏差”,一笔带过。
行动:标签集。 在监督学习里,网络的行动是从标签集里挑一个标签(在强化学习里,则是从事先定好的一组动作里挑一个)。这个集合在训练前就定好了,但它未必就是部署时要做的决定。人脸识别是个典型的例子:训练时是闭集分类,在固定的一批身份里挑一个;部署时却是开集使用,要面对训练中从没见过的人,回答“这两张脸是不是同一个人”或者“这个人在不在库里”。医疗场景也类似:从预测到决定之间常常还隔着一步,比如要不要安排活检、请人复核,或者暂不作答,而这一步在训练时并不出现。这本质上是训练与部署之间的错位。1.3 节提到的 Chow 拒识选项,就是把其中一个决定直接加进了行动空间;几十年后,它以选择性分类(selective classification)和学会转交(learning to defer)的形式重新出现[37, 38]。
损失:预测与标签的差距。 损失衡量预测与标签之间差多少,而这个差距怎么算,决定了哪些错误更要紧。以图像分类为例,最常用的评测指标是 top-1 和 top-5 准确率:只看正确标签是否排在模型预测的第一位,或者前五位之内。这相当于 0–1 损失,把老虎认成猫,和把杯子认成碗,代价一样。早期的 ImageNet 挑战赛还算过一种层级代价,在相近类别之间出错时扣分较少;但它给参赛作品排出的名次与 top-5 错误率相同,所以从 2012 年起就只用 top-5 了[39]。就排名而言,这个决定合理;可从此以后,“一个错误有多糟”很少再进入评测。一直有研究想把它补回来,比如在准确性与具体程度之间做权衡[40],以及“犯更好的错误”[41]。
准则:训练集上的平均。 大多数训练目标是对训练样本等权取平均。这相当于一个贝叶斯准则,先验就是各类情况在数据集里碰巧出现的频率。也有做法会给样本重新加权,比如按类别频率做平衡,但默认的仍是等权平均。于是常见的类别和常见的条件占了主导;罕见的情况几乎不占分量,哪怕在那里出错代价很高。Wald 的另一个选项,即只看最坏情况,后来以分布鲁棒优化(distributionally robust optimization)的形式重新出现:它最小化的是最差群组或邻近的最差分布上的风险[42]。
这些默认设置大多来自基准文化。要让不同方法的进展可以比较,问题就得固定下来:同一个数据集、同一套标签、同一个评测指标、同样的平均方式。
损失之所以成了焦点,还有一个原因:四个部分里,只有它能直接交给梯度下降去优化,于是算力、数据和架构上的进步,大多用在了把损失压得更低上。也有不少工作在尝试把原本由人来定的部分交给学习:强化学习让智能体自己收集数据;元学习从一批任务里学出先验;逆强化学习和 RLHF 的奖励模型,则从人的示范和偏好里学出损失本身。但它们的做法,通常是把要自动化的那一部分再写成一个新的损失去优化,焦点依旧落在损失上。
2.2 · 对损失更准确的批评
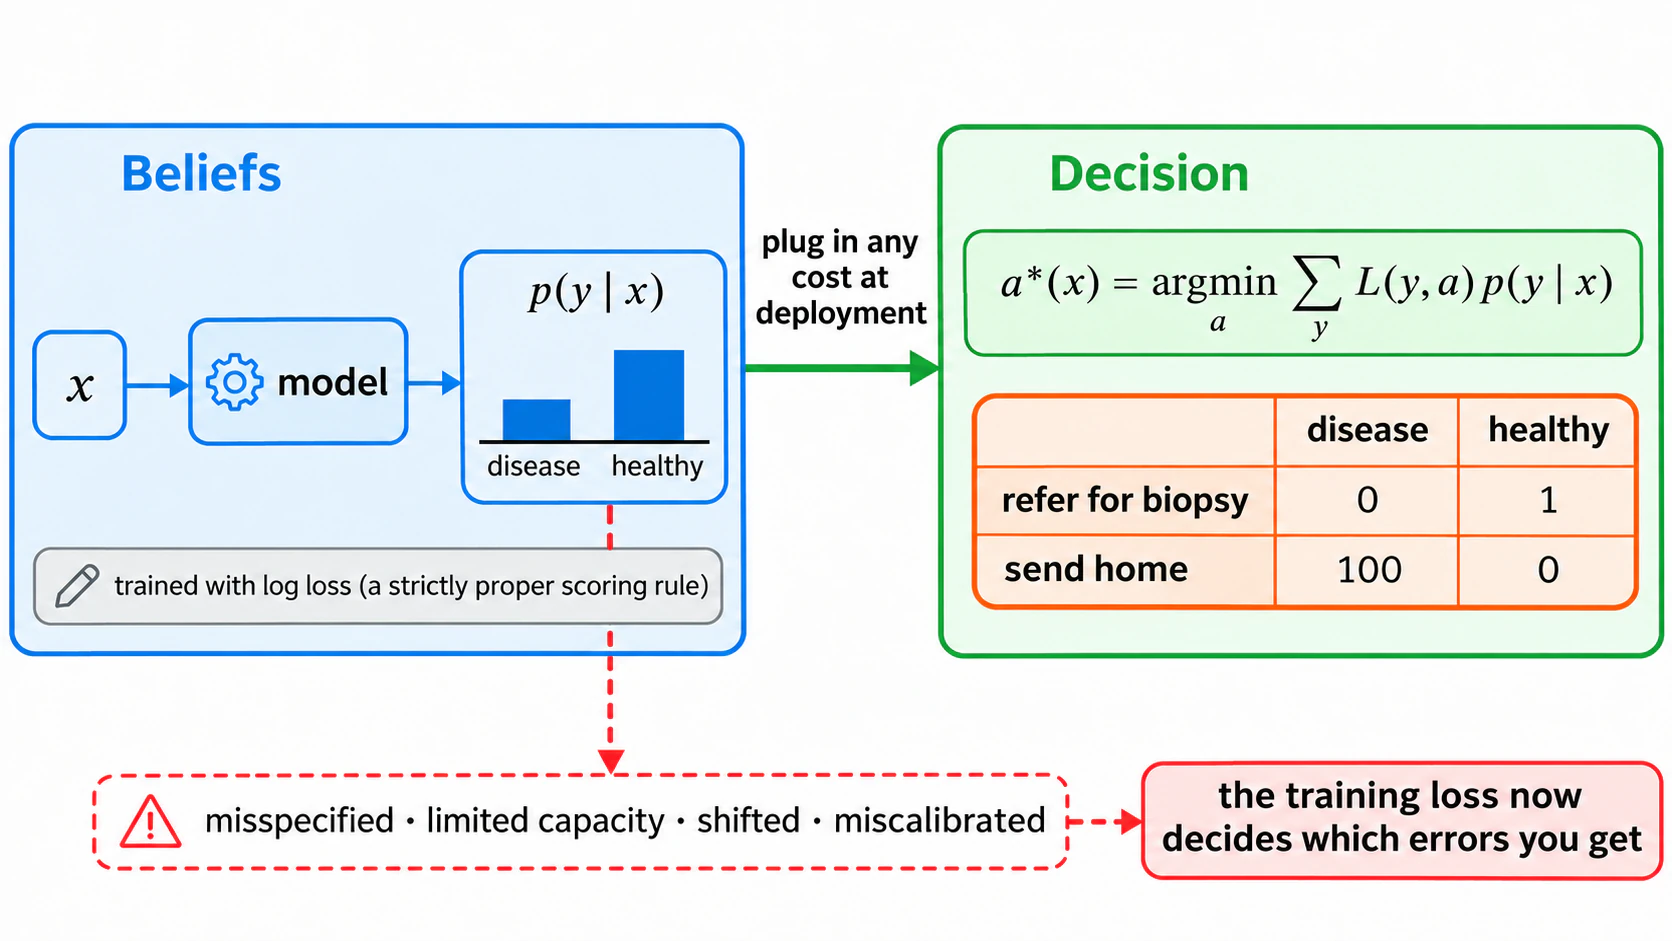
一种常见的批评是:每个损失都编码了价值判断,而交叉熵编码的判断是错的,因为现实中的后果并不呈对数形式。这个批评混淆了两种都被叫作“损失”的东西:训练时用来给模型打分的损失,和部署时真正用来做决策的损失。两者之所以不同,根本原因正是 2.1 节讲的行动空间的错位:训练时模型输出的是各个标签的概率,部署时要做的却是具体的决定。
两者打分的对象不同。部署时在乎的是决策损失(decision loss):它给具体的行动打分,反映这样做的后果有多糟,比如 0–1 损失、代价矩阵、作为代价使用的平方误差,直接表达价值判断。训练时用的交叉熵则是一种评分规则(scoring rule):它给信念打分,也就是给模型报告的概率分布打分,看它和实际发生的结果有多相符。放在 Wald 的框架里,评分规则也是一种损失,只是它的“行动”是报告一个概率分布。
对数损失是严格恰当的(strictly proper):只有报告真实的条件分布,才能让它的期望值最小[43]。这只说明在理想情况下,最好的报告就是真实分布;实际训练出来的模型离它有多近,校准是可以检验的一面。所谓校准,是指概率说得准:模型说“八成是这一类”的那些样本里,确实约有八成属于这一类。如果模型报告的 $p(y \mid x)$ 接近真实的条件分布,那么在决策时可以接上任何代价矩阵,因为最优决策只需要两样东西:每种结果的概率,和每个行动在每种结果下的代价。把代价按概率加权,选期望代价最小的行动即可:
$$a^{\ast}(x) \;=\; \arg\min_{a} \sum_{y} L(y, a)\, p(y \mid x),$$
这就是贝叶斯决策理论里推断与决策的分工(Bishop[44],1.5 节):概率属于 Wald 框架里的世界与观测,代价属于损失。交叉熵关注的是模型给实际发生的结果分了多少概率,作用是让模型如实报告这些概率;各种错误分别有多严重,则是在决策时用代价矩阵直接衡量的。因此,交叉熵不必与现实中的后果一致。
两类损失最容易混在一起的地方是平方误差,因为它在一个公式里同时担任两种角色。作为代价,它说大一倍的误差要糟四倍。作为似然,它是高斯噪声的负对数密度,由此得到的后验均值,正是平方损失下的贝叶斯估计。所以我们用平方误差时,它可能是在表达代价:大的误差格外严重;也可能是在表达对噪声的假设:噪声服从高斯分布。用的人通常不会说明是哪一种。
对交叉熵更准确的批评是:训练和部署用不同的损失,本身并不要紧,前提是信念正确。信念正确时,训练只管把概率学准,部署时接上什么代价矩阵,都能做出最优的决定。可模型往往做不到处处正确,比如模型设定错误、容量有限、分布偏移或校准不佳(现代网络常常校准不佳[45])。这时它总要在某些地方出错,而错在哪里,由训练损失决定。交叉熵只按各种情况在数据里出现的频率分配注意力,并不知道部署时哪种错误更昂贵。在图 6 的例子里,把患病的人送回家,代价是让健康的人去做活检的一百倍,交叉熵对此一无所知。于是模型可能恰好错在代价最高的地方,训练与部署之间的错位这才真正造成了损失。代价敏感学习[46]和面向决策的学习[47]因此把决策的代价直接放进训练:既然模型总会犯错,就让它把错误犯在代价低的地方。
语言模型是这种分离在当代最干净的例子。预训练时,模型用交叉熵预测下一个词,学到的是关于文本的信念,完全不用考虑之后会被拿来做什么。可部署时,模型要做的是具体的决定:怎样回答一个问题,要不要拒绝一个请求,什么时候该说“不知道”。预训练学到的信念并不完美,而且它学的是网上的文本通常怎样接下去,这和一个有用的回答应该怎样写,并不是同一件事。后训练就是为了矫正这一步:指令微调和基于人类反馈的强化学习,把部署时在乎的东西放回了训练里[48]。但后训练用的目标,比如奖励模型给出的分数,本身也只是我们真正在乎的东西的代理。
2.3 · 奖励黑客与决策理论的回归
一个系统被用力优化时,它压低的确实是我们给定的那个损失,但压低的办法可能完全出乎我们的意料,也不是我们真正想要的。这类现象通常称为奖励黑客(reward hacking)。规格博弈(specification gaming)的案例集里,有一个赛艇智能体,靠没完没了地绕圈撞同一批目标来刷分;还有一个俄罗斯方块智能体,靠暂停游戏来避免输掉[49]。Gao、Schulman 和 Hilton(2023)[50]在语言模型中测量了这一效应。策略对着一个学到的奖励模型优化得越深,奖励模型的分数就一路上升,而留出的金标准奖励先升后降。基准测试在整个领域的尺度上表现出同样的规律:一个数字一旦成为目标,方法就会朝这个数字漂移。这就是 Goodhart 定律在训练里的形态,Manheim 和 Garrabrant(2018)[51]区分了它的几种变体。
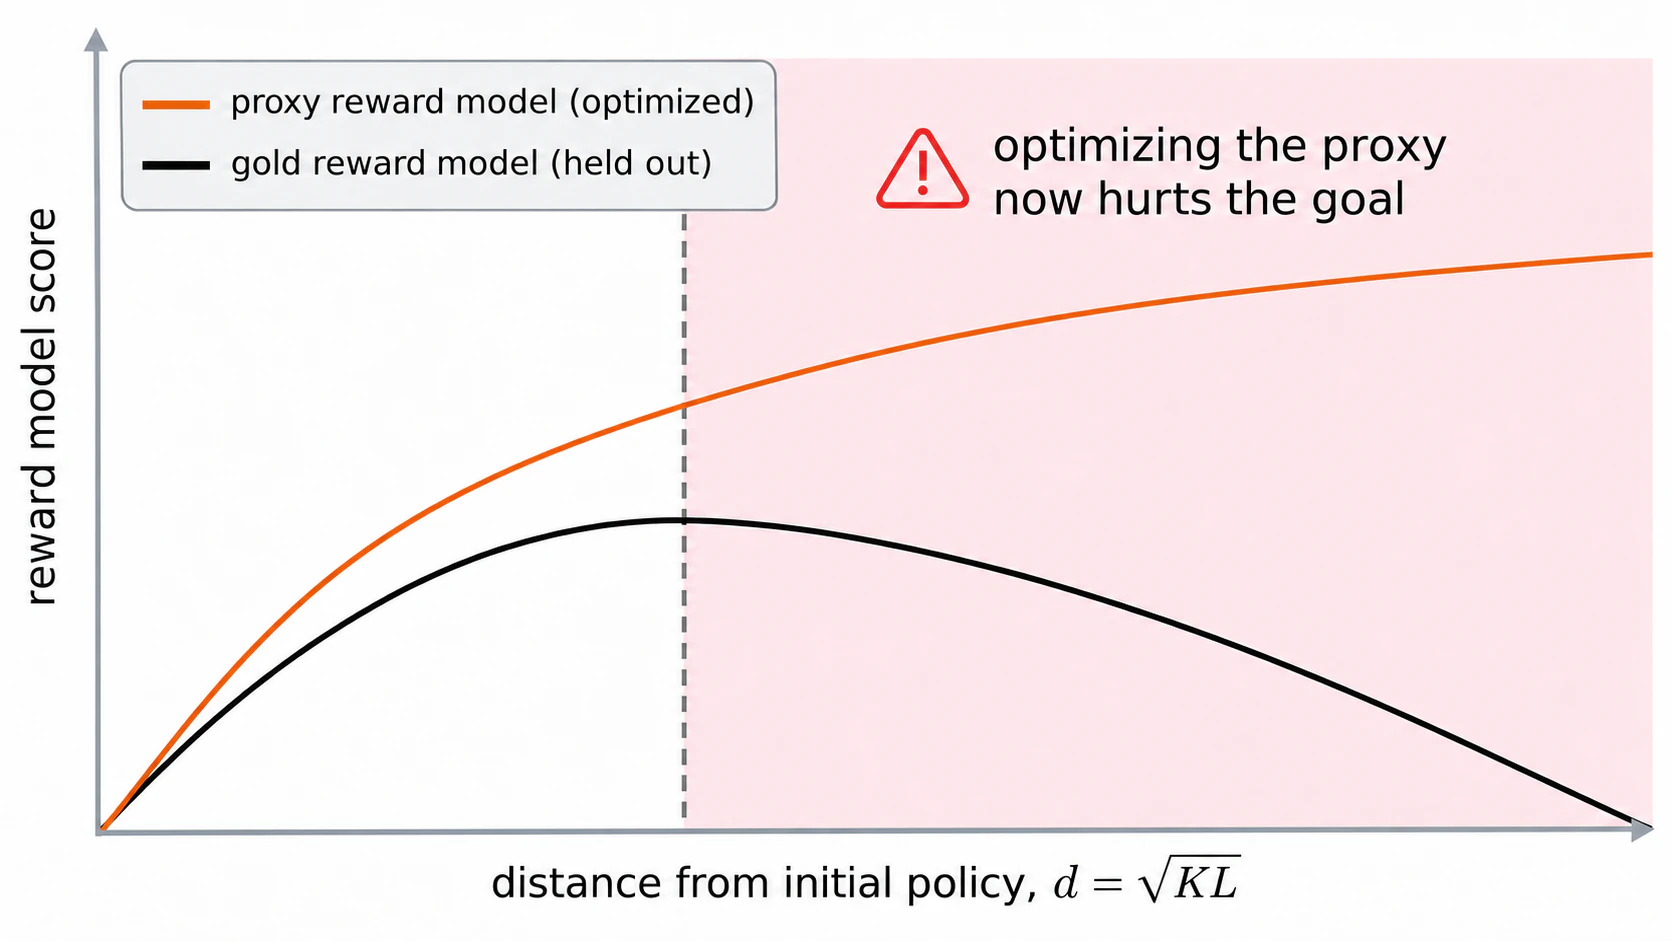
决策理论也是在后训练中回归的。RLHF 用 Bradley–Terry 模型,根据人的两两比较拟合出一个奖励模型,
$$P(y_1 \succ y_2 \mid x) \;=\; \sigma\big(r(x, y_1) - r(x, y_2)\big),$$
这就是数学心理学中的 Luce 选择公理[52, 53]。接着,它最大化这个奖励,同时对偏离参考策略施加惩罚[48, 54, 55]:
$$\max_{\pi}\; \mathbb{E}_{y \sim \pi}\big[r(x, y)\big] - \beta\, \mathrm{KL}\big(\pi(\cdot \mid x)\,\|\,\pi_{\text{ref}}(\cdot \mid x)\big), \qquad \pi^{\ast}(y \mid x) \;\propto\; \pi_{\text{ref}}(y \mid x)\, e^{r(x, y)/\beta}.$$
右边的解,是带信息处理代价的有限理性的标准形式[56],也是直接偏好优化(direct preference optimization)所依据的恒等式[57]。后训练重建了 Wald 框架中的三个部分:奖励 $r(x, y)$ 是一个显式的效用,对应损失,只差一个负号;Bradley–Terry 模型描述人怎样根据效用做选择,把看不见的效用和看得见的比较联系起来,相当于世界与观测里的观测模型;最后得到的策略在效用与偏离代价之间权衡,对应行动里的决策规则。
数据筛选的问题也在这里出现了,形式正是 Wald 在 1943 年遇到的那种。偏好数据只来自那些被模型采样出来、拿给人看过、又被人打了分的输出。换句话说,奖励模型学习的是“那些返航的飞机”。
Wald 在 1939 年的观点依然成立:损失确定之后,数学会告诉我们采取怎样的行动最好;至于损失本身,也就是它取什么形式、给每种结果定多大的代价,并不由数学来决定。然而,RLHF 已经往前多走了一步:它的奖励模型是一个关于人们想要什么的假说,是从人们的选择中推断出来的。从行为推断目标,再检验这个推断站不站得住,正是规范建模要做的事。相比之下,RLHF 通常只做一次:在固定的假设下推断出奖励模型,然后把它冻结进优化器,很少回头检验这个推断。第三部分会详细讨论,规范建模怎样把这件事做得更完善。
第三部分 · 规范建模:如果我们把损失当作假说?
看到一个系统做出某种行为,无论它是人、动物还是一个训练好的智能系统,怎样才算理解了这个系统?智能系统都是被进化、学习或训练朝着某些目标塑造出来的,所以理解它,关键在于回答两个问题:它的目标是什么,它的行为离这个目标有多近。这两个问题要紧,有三个原因。第一,知道目标,就能预测系统在没见过的情形下会怎样做:条件变了,最好的做法会以可以推算的方式跟着变,系统的行为也会跟着变。第二,知道离目标有多远,就能诊断它卡在哪里:差距来自信息不够、能力受限,还是目标本身,需要的补救各不相同(3.2 节)。第三,对 AI 来说,这直接关系到它是否在做我们想要的事;奖励黑客正是系统实际追求的目标和我们的意图之间出现了差距。
描述性模型和机制模型都回答不了这两个问题。描述性模型(descriptive model)记录系统做了什么,可记录只覆盖见过的情形,换一个没见过的条件,它就说不出系统会怎样做;对足够复杂的系统,要把行为完整描述下来,往往找不到比系统本身更简单的写法。机制模型(mechanistic model)弄清系统内部怎样运转,可人工神经网络是一个现成的反例:它的每一个参数、每一步推理、梯度怎样传播、数据怎样流动,我们全都知道,却仍然说不清它到底在做什么,更谈不上完全掌控它。解释应当是一个比系统小得多、又能预测新条件下行为的描述[58];用这个标准衡量,这两类模型都难达标(4.1 节会细说)。回答这两个问题,是规范模型(normative model)的工作。
要度量一个系统的行为离它想达到的目标有多近,我们需要一个参照:在给定的条件下,朝着这个目标,最优的行为应该是什么样子。这本身是一个规范问题。第一部分已经给出了回答这类问题的框架:写下世界、可选的行动、损失和汇总方式,最好的做法也就随之确定。因此,规范建模(normative modeling)就是用这个框架去理解一个系统:先假设系统面对的是怎样的问题,包括它所处的环境、它受到的约束和它在意的损失;再推导出在这个问题下应该怎样做;最后拿这个“应该”去对照系统实际怎样做,尤其是在它没见过的条件下。两者吻合,说明我们对问题的假设很可能抓住了要点;相差很远,就要回头修改假设。“规范”二字,指的就是这个“应该”。
熟悉 Marr(1982)[59]信息处理系统三个层次的读者,对这个思路不会陌生:计算层面问系统要解决什么问题、为什么这样解决;算法层面问用什么表示和步骤去解决;实现层面问这些步骤在物理上怎样实现。规范建模显然落在计算层面,回答的正是上面那个关于目标的问题。这种思路最早在知觉和运动研究里成形:信号检测论和理想观察者把知觉写成了决策问题,运动控制里的最优化理论把动作也写成了决策问题(1.3 节)。早期的规范模型多以资源不限的理想智能体为参照,比如理想观察者只受刺激本身的噪声限制,不考虑大脑处理信息的能力有限。后来的资源理性分析把算力和时间也写进约束,“最优”的意思随之变成“在现有资源下最好”[34, 35]。
今天的规范建模,大致可以概括为三步[60, 61]:
- 找出系统要解决的任务,写下它的约束和目标;
- 推导出在这些条件下最好的行为应该是什么样子,并与数据比较;
- 如果吻合,就用这个模型去预测新情境下的行为;预测不中,就回头修改设定,包括对环境、约束和目标的假设。
这种建模方式几乎不涉及机制。不同的大脑可以产生近乎相同的最优行为,模型没有办法区分它们;同样,即使行为符合贝叶斯最优,也不能说明大脑或智能系统内部真的表示了先验、计算了似然。另一方面,它也不假定行为是完美的:行为从来不是最优的,只是足够好,并且能被模型很好地预测[61]。
3.1 · 规范建模里的四个部分
规范建模是一种分析系统目标的方法。工程里当然也分析目标:RLHF 的目标函数是从偏好模型和 KL 约束推导出来的,代价敏感学习和面向决策的学习也是例子。但更常见的做法是直接在训练损失上提出新形式,用基准成绩检验,很少先写明部署任务要求什么、系统受什么约束,推导出它应该怎样做,再回头检查训练出的系统实际在做什么。规范建模把这三步摆在明处。
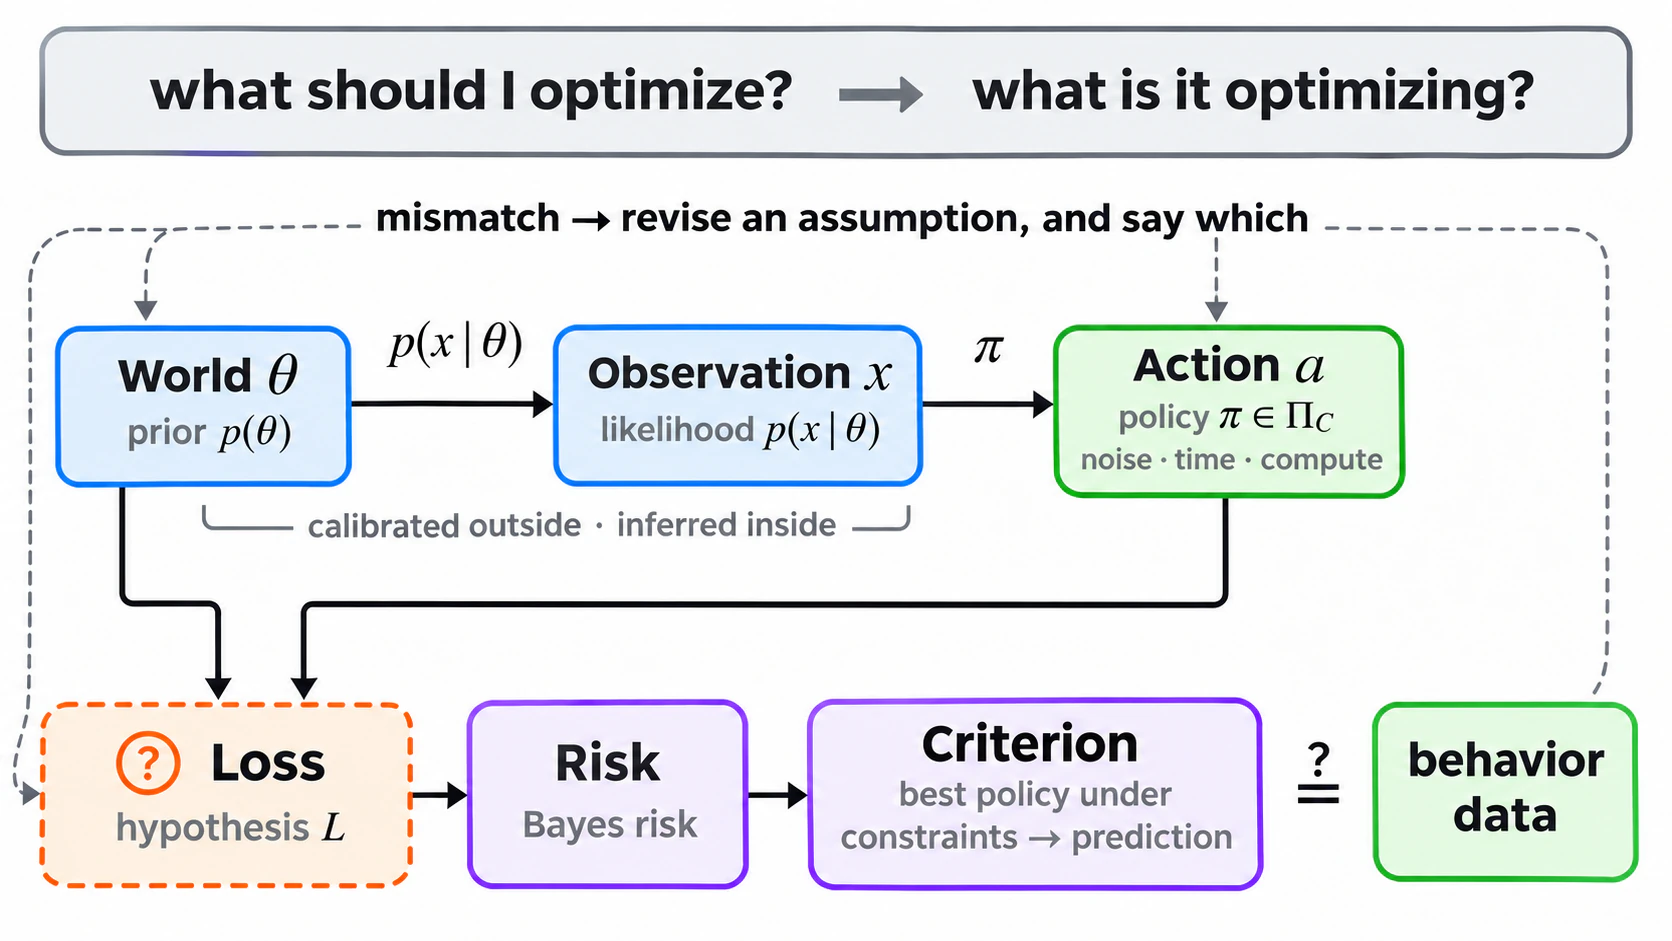
这套方法原本是为理解已有的系统发展出来的,但同样可以用来构造系统。监督学习从数据中学参数,损失是给定的;规范建模决定的正是这个给定的东西:训练前,先说清任务要求什么、系统受什么约束,损失和评价标准由此而来;训练后,再检查系统实际在优化什么,不合就回头改。这是一个循环。省掉它,关于系统目标的假设就在选损失的那一瞬间写完了,而且往往不被当成假设。放到 Wald 的四个部分里看:
- 世界与观测变成一个生成模型,$p(\theta)$ 和 $p(x \mid \theta)$。实验者可以校准环境的统计规律;系统对这些规律内化了多少,则要靠推断。两者是不同的对象。
- 行动变成一个策略类 $\Pi_C$,系统的约束都写在里面:感觉与运动噪声、时间、记忆、算力。
- 损失变成假说,行为就是检验。
- 准则通常是贝叶斯风险。在给定约束下推导出最优策略,再与系统的实际做法比较。
造一个智能系统时,世界模型、策略约束和损失同样是一个个假设:数据的分布、架构与算力、训练损失。预测与行为不一致时,不做规范分析,连哪些假设在起作用都没有写下来,更无从知道是哪一个出了错。写下来了,也要逐个修订、重新推导,并说明改的是哪个,因为不一致本身并不能指出是哪个假设出了错。
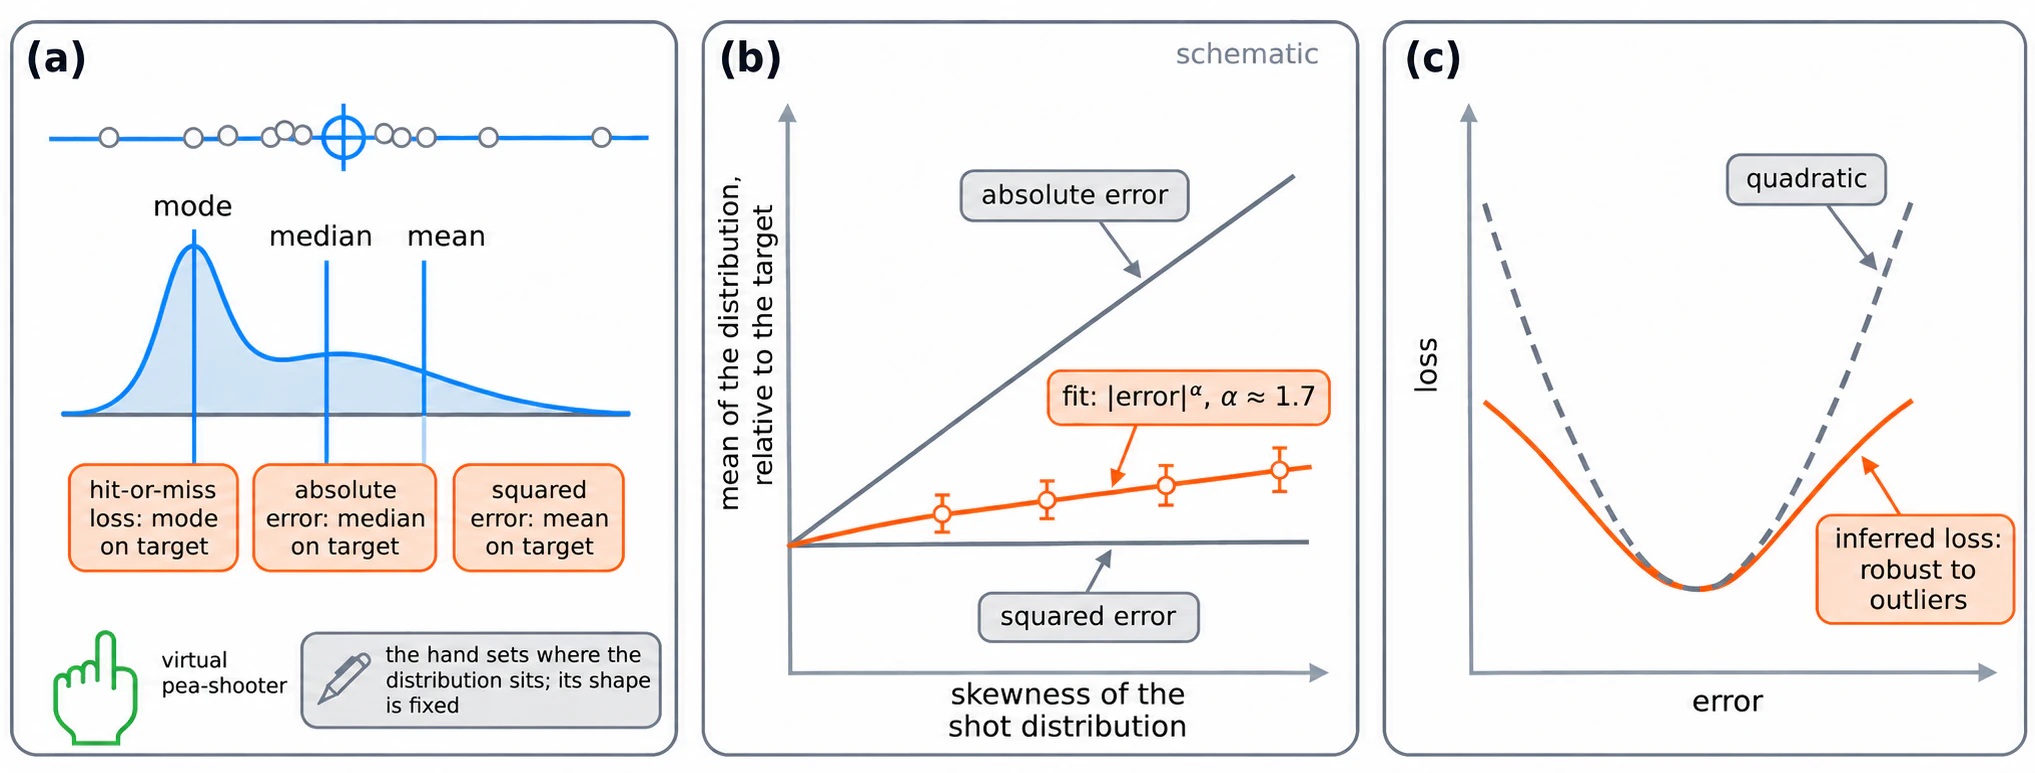
训练后检查系统实际在优化什么,听起来只能靠猜,其实有办法做,而且在人身上早就做过[62]。实验里,被试用食指移动,调整一支虚拟豌豆枪相对于目标线的位置。每一发的落点都带有随机误差,误差服从一个偏斜分布:手决定分布落在哪里,实验者决定分布的形状。对偏斜分布而言,均值、中位数和众数位于不同的位置,而在不同的损失下,该对准目标的最佳点也不同:平方误差偏好均值,绝对误差偏好中位数,“中或不中”的损失偏好众数。因此,人们把分布放在哪里,就揭示了他们的行为看起来是在最小化哪种损失。他们放置的位置落在平方误差和绝对误差的预测之间,更靠近平方误差。推断出的损失不是平方误差,也不是任何一种教科书里的默认选项:对小误差接近二次,对大误差增长更慢,群体幂律拟合的指数是 $1.72 \pm 0.03$,低于平方误差的 2,正是对离群值稳健的形状。这一推断在假定的损失族和任务模型之内做出,所以说它是测量,是在“拟合出的参数也算测量”的意义上说的。但系统实际在优化什么,确实可以从行为里推断出来,而推断出的答案和随手选一个默认损失相去甚远。对一个训练好的模型,同样的做法是改变任务的统计规律,看它的行为怎样变,再推断它的 $L$。
讲到这里,正好可以把 AI 讨论中都被叫作“目标”(the objective)的三样东西区分开。
| 是什么 | 以 RLHF 为例 | |
|---|---|---|
| 任务评估 $J$ | 我们想要达成什么,以及怎样给成功打分 | 人对“是否有帮助”的判断;金标准奖励 |
| 训练损失 $\ell$ | 实际塑造参数的信号 | 学到的奖励模型加上 KL 惩罚 |
| 行为目标 $L$ | 在给定约束下,与系统行为相一致的目标 | 训练好的策略看起来在最大化的东西 |
第二部分讲的是 $J$ 与 $\ell$ 之间的差距。规范建模关心的是 $L$:推断它,检验它,再把它与 $J$ 比较。三者可能各不相同,知道其中一个,推不出另外两个。
对齐研究里有一套现成的对应。Hubinger 等人(2019)[63]把系统的行为看起来在优化的目标叫作行为目标(behavioral objective),也就是完美的逆强化学习能恢复出的东西,本文的 $L$ 沿用这个用法;$J$ 与 $\ell$ 的差距对应他们说的外部对齐问题,$\ell$ 与 $L$ 的差距对应内部对齐问题。他们还定义了系统内部真正在优化的目标(mesa-objective),本文不用它,因为那是一个机制主张,而规范建模几乎不涉及机制。
3.2 · 理想、受限与实际
3.1 节讲的是目标:损失是假说,行为是检验。这一节讲差距:行为离目标有多近。要度量差距,先得有参照,也就是在这个目标下最好能做到什么程度。参照最好有两个。
在损失假说 $L$ 之下,固定环境 $p(\theta)$ 和 $p(x \mid \theta)$。一个策略的贝叶斯风险是
$$\mathcal{R}(\pi) \;=\; \mathbb{E}_{\theta \sim p(\theta)}\, \mathbb{E}_{x \sim p(x \mid \theta)} \big[\, L(\theta, \pi(x)) \,\big].$$
两个参照分别是不加、以及加上我们选择建模的那些约束时的最优策略:
$$\pi_{\text{ideal}} \;=\; \arg\min_{\pi \in \Pi} \mathcal{R}(\pi), \qquad \pi_{\text{bounded}} \;=\; \arg\min_{\pi \in \Pi_C} \mathcal{R}(\pi), \qquad \Pi_C \subseteq \Pi.$$
理想智能体看到的 $x$ 与系统完全相同。它没有额外的信息,只是摆脱了模型中设定的内部噪声、时间和算力限制。它自己的风险 $\mathcal{R}(\pi_{\text{ideal}})$ 也不是零:这个下限由 $x$ 携带的信息决定,任何系统都越不过去。受限(bounded)智能体代表在这些限制下任何系统所能做到的最好程度。如果实际策略位于 $\Pi_C$ 之内,它与理想之间的差距可以一分为二:
$$\mathcal{R}(\pi_{\text{actual}}) - \mathcal{R}(\pi_{\text{ideal}}) \;=\; \underbrace{\mathcal{R}(\pi_{\text{bounded}}) - \mathcal{R}(\pi_{\text{ideal}})}_{\Delta_1 \,\geq\, 0} \;+\; \underbrace{\mathcal{R}(\pi_{\text{actual}}) - \mathcal{R}(\pi_{\text{bounded}})}_{\Delta_2 \,\geq\, 0}.$$
$\Delta_1$ 是我们所建模的约束的代价:噪声这么大、时间这么少、算力只有这么多时,任何系统都必然要差多少。$\Delta_2$ 是其余的一切:学习可能尚未完成,算法可能只是近似,损失假说可能有误,也可能有我们遗漏的约束。1.3 节的效率,就是这种比较的早期版本。
这里的“受限”指受约束策略类中的最优策略,即 Russell 和 Subramanian 的有限最优性(1.3 节),与计算理性(computational rationality[64])和资源理性分析相近;Simon 意义上的满意化(satisficing[65])是这个词的另一种用法。
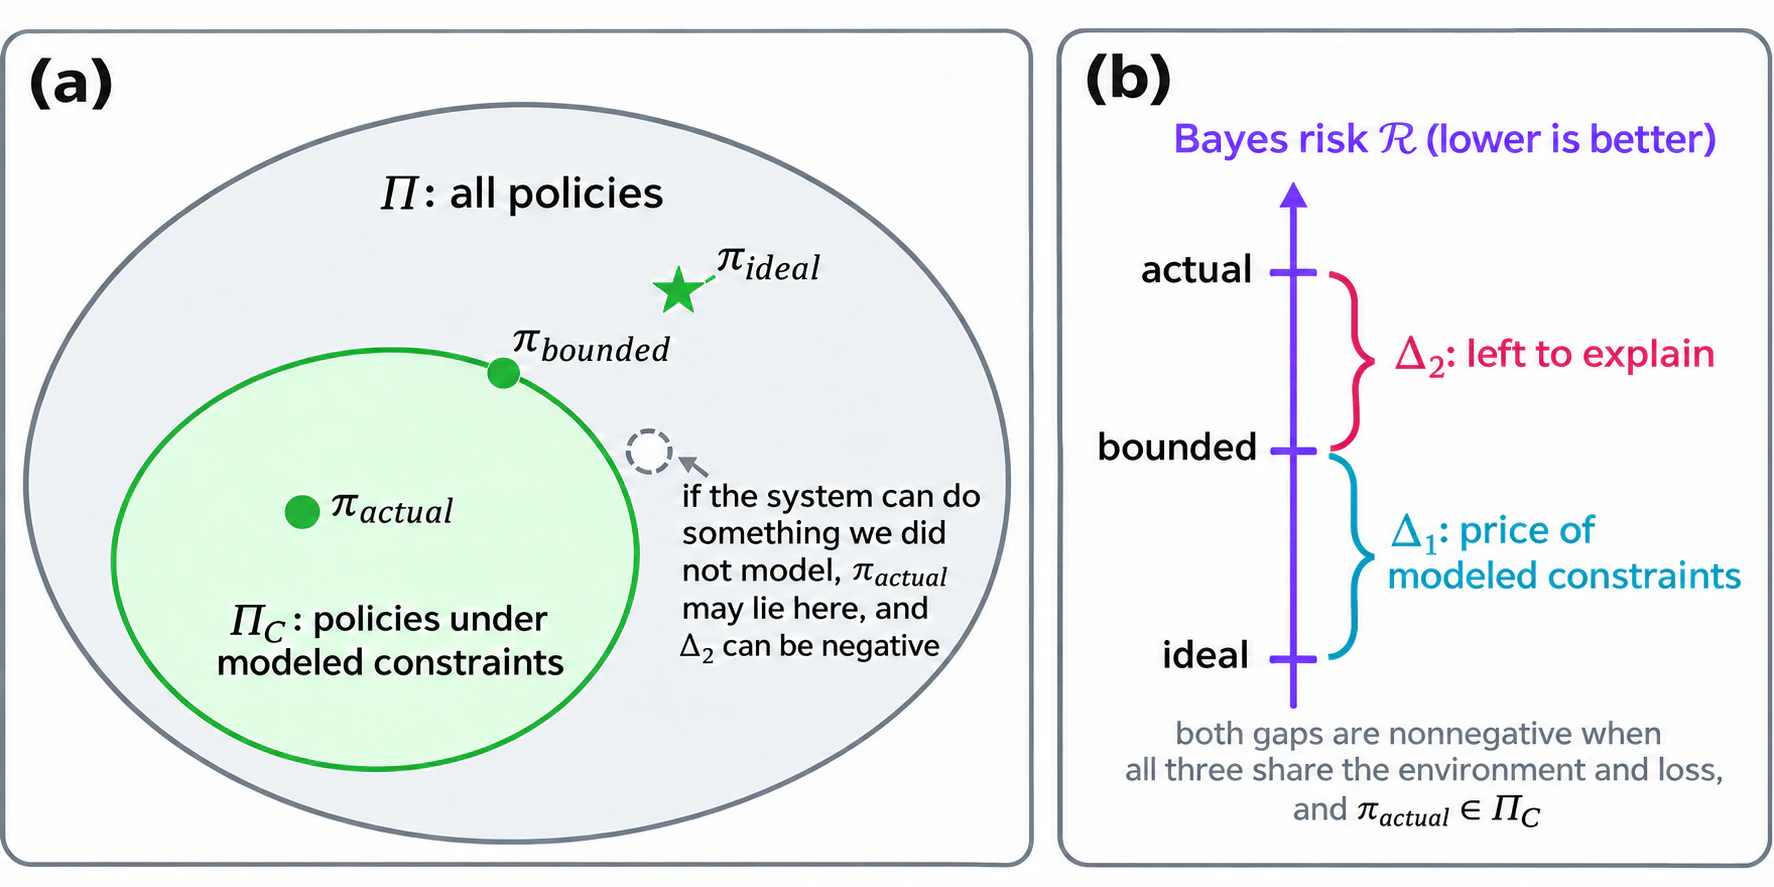
要把两段差距都解读为非负,三个策略必须共享同一个环境和同一个损失,实际策略还必须位于 $\Pi_C$ 之内。如果系统能做到我们的约束模型所排除的事,$\pi_{\text{actual}}$ 就落在 $\Pi_C$ 之外,$\Delta_2$ 可能为负,而这本身就是信息:约束模型错了。
把理想观察者和受限参照放进同一个比较里,差距才变成了线索。$\Delta_1$ 大,说明在这些约束下任务本身就难,系统可能已经做到了几乎任何系统所能做到的程度。$\Delta_2$ 大,说明还有东西有待解释。对一个我们自己训练的系统,这个拆分直接对应两类干预。$\Delta_1$ 是我们选定的参数量和算力带来的代价,扩大规模缩小的正是它。$\Delta_2$ 是优化没有找到约束之内的最优、算法只是近似、损失假说有误或约束有遗漏,这些靠规模缩不小,要改的是训练和目标。差距落在哪一段,决定该往哪边下手。
扩展定律(scaling laws)量的正是 $\Delta_1$。Hoffmann 等人(2022)[66]把语言模型的测试损失拟合成 $E + A/N^{\alpha} + B/D^{\beta}$:$E$ 是任何模型都越不过的下限,对应 $\mathcal{R}(\pi_{\text{ideal}})$;后两项是参数量和数据量的代价,对应 $\Delta_1$ 沿这两个轴的切片。差别有三点。第一,扩展定律量的是训练损失 $\ell$ 之下的差距,不是任务 $J$ 之下的。第二,$E$ 是在同一个模型家族内拟合出的渐近值,整个家族共有的限制在这里看不见;规范模型的理想参照来自家族之外。第三,扩展定律把数据量当作约束算进了 $\Delta_1$;按本节的设定,数据不够本来属于 $\Delta_2$ 里的“学习尚未完成”。
这种搬动不总是合法的。每当 $\Delta_2$ 出现,你都可以编造一个约束,把它挪进 $\Delta_1$;编得够多,任何系统看起来都是最优的。一个约束能不能算进 $\Delta_1$,标准只有一个:它要有独立于待解释行为的证据。要么能单独测出来,比如感觉噪声在另一个任务里量得;要么能改变它,差距随之按预测移动,扩展实验在参数量和数据量上做的就是这件事。既测不出也动不了的约束,只是一个自由参数,它顶着的那部分差距仍然是 $\Delta_2$。而且能搬动的不只是约束:损失、先验和约束之间也能相互抵换。这是下一节的主题。
3.3 · 从行为定目标,还需要什么?
分析一个智能系统,能看到的只有行为:一条轨迹、一组决策、一批数据。从行为推目标是最直接的想法,也有深厚的传统。Savage(1954)[67]证明,只要一个人在各种赌注之间的偏好满足几条公理,就能从这些偏好里同时推出他对世界的概率判断和对后果的效用,两者都是唯一的(效用相差一个仿射变换)。这正是从行为定下先验和损失。
那么,有了一个关于目标的假说,能不能直接拿观察到的行为去验证它?答案是不行,原因就藏在 Wald 的理论里。
先说一个无伤大雅的情况。对任意 $c > 0$ 和任意函数 $b(\theta)$,损失 $c\,L(\theta, a) + b(\theta)$ 导出的最优策略与 $L$ 完全相同。损失最多只能识别到相差一个缩放因子和一个随世界而变的偏移量。
下一个问题更严重。贝叶斯决策对先验和损失的依赖,只通过两者在后验期望损失中的乘积体现,
$$\int L(\theta, a)\, p(x \mid \theta)\, p(\theta)\, d\theta.$$
把先验乘以任意正函数 $g(\theta)$ 并重新归一化,再把损失除以 $g(\theta)$,所有决策都保持不变。仅凭选择,无法区分“认为某种世界更罕见、但代价更高”和“认为它更常见、但代价更低”。这种交换要求损失不受约束。把损失限定为只依赖误差 $\theta - a$ 的函数,就排除了这一种交换;但能否识别,仍然取决于数据:在高斯噪声下,任何随误差增大的对称损失都预测同一个瞄准点,所以 3.1 节的豌豆枪实验才把误差分布做成偏斜的。噪声、信息限制和目标之间,也可以用类似的方式相互抵换。对这类互换研究最深的是经济学的结构估计:在动态离散选择模型里,效用、折扣因子和扰动分布不能联合识别,总要先固定其中一部分[68]。
Wald 的完全类定理(complete class theorem)把这一点推向一般。在温和的条件下,每一条可容许的(admissible)决策规则,都是某个先验下的贝叶斯规则,或者是贝叶斯规则的极限[4]。因此,几乎任何合理的行为,对某个先验和损失而言都是贝叶斯最优的。单独一句“这个系统是贝叶斯的”,更像一种描述语言,算不上一个假说。逆强化学习里早有同一个事实:一个最优策略对应无穷多个奖励,常数奖励也在其中[69]。
Savage 的定理之所以成立,是因为它要求的不是一次观察,而是对所有赌注的偏好,并且假定效用不随世界而变。放到 Wald 的框架里,这就是从行为定目标还需要的两个条件。第一,目标之外的部分,也就是环境和约束,要由行为以外的证据定下,或者由结构假设限定。第二,行为要在不同的条件下看过:一种条件只给一个点,条件变了,不同的目标假说才给出不同的预测。最好的实验早就是这样做的。Ernst 和 Banks(2002)[70]在只有单一线索的条件下,分别测量了视觉噪声和触觉噪声,然后预测两种线索同时出现时人会如何加权,没有留下任何需要拟合的参数。预测成立了。一个规范模型的参数里,用它要解释的那批数据拟合出来的越少,它就越可信。识别到等价类也不是失败。同一个等价类里的目标,在所有条件下预测相同的行为,对预测而言它们就是同一个假说,Savage 的效用也只定到仿射变换为止。需要分开的,只是预测不同的那些,这正是第二个条件的用处。
著名的结果也应受到同样的审视。Duffy 等人(2022)[71]逐个试次重新分析了 Körding 和 Wolpert(2004)[19]的数据,认为贝叶斯学习的证据来自取平均,而单个试次呈现的是近因偏差。无论对那项研究作何结论,这件事都说明了一点:我们分析行为的方式,本身就可能制造出最优的表象。第四部分会借一块微处理器把这一点推得更远,也会说明上面的两个条件,在我们自己训练的系统上为什么都能满足。
3.4 · 三个问题
合起来看,无论对人工系统还是对人,规范建模都归结为三个问题。
- 目标从哪里来?它们如何塑造学习与行为?
- 理想系统能做到什么?在现实约束下能做到什么?实际系统与它们相比如何?
- 这些差距中,哪些揭示了系统的性质,哪些只是我们的假设或评估方法造成的假象?
对大脑而言,每个问题都很难。任务需要推断,先验是学来的、看不见的,约束有一部分未知,演化塑造出的目标只能靠猜。研究一种行为,可能要花上好几年精心设计的实验。对 AI 而言,这些未知量几乎每一个都是我们亲手写下的,或者本可以写下来。这种不对称是第四部分的主题。
第四部分 · 为什么规范建模应该在现代 AI 中落地
对大脑做规范建模很难:四个部分几乎没有一样是确知的,3.3 节的两个条件都不容易满足。知觉、运动学习和认知神经科学仍然坚持这样做,因为别的方法回答不了目标的问题(第三部分),代价是每个结论都要靠多年的实验。在 AI 中,这些东西有很多就在我们自己的代码里。这一部分要说的是,AI 格外适合做规范建模,也格外需要它:对我们自己训练的模型,两个条件都能满足;3.1 节的那个循环,训练之后推断系统实际在优化什么、再回头改训练,在这里能闭合,而且能重复;同时,对内部的完全可及并没有带来理解(4.1 节)。最后会看到,这种做法已经在推进了,有的打着这个名号,更多的没有。
4.1 · 全都可及,但为什么仍然不能理解?
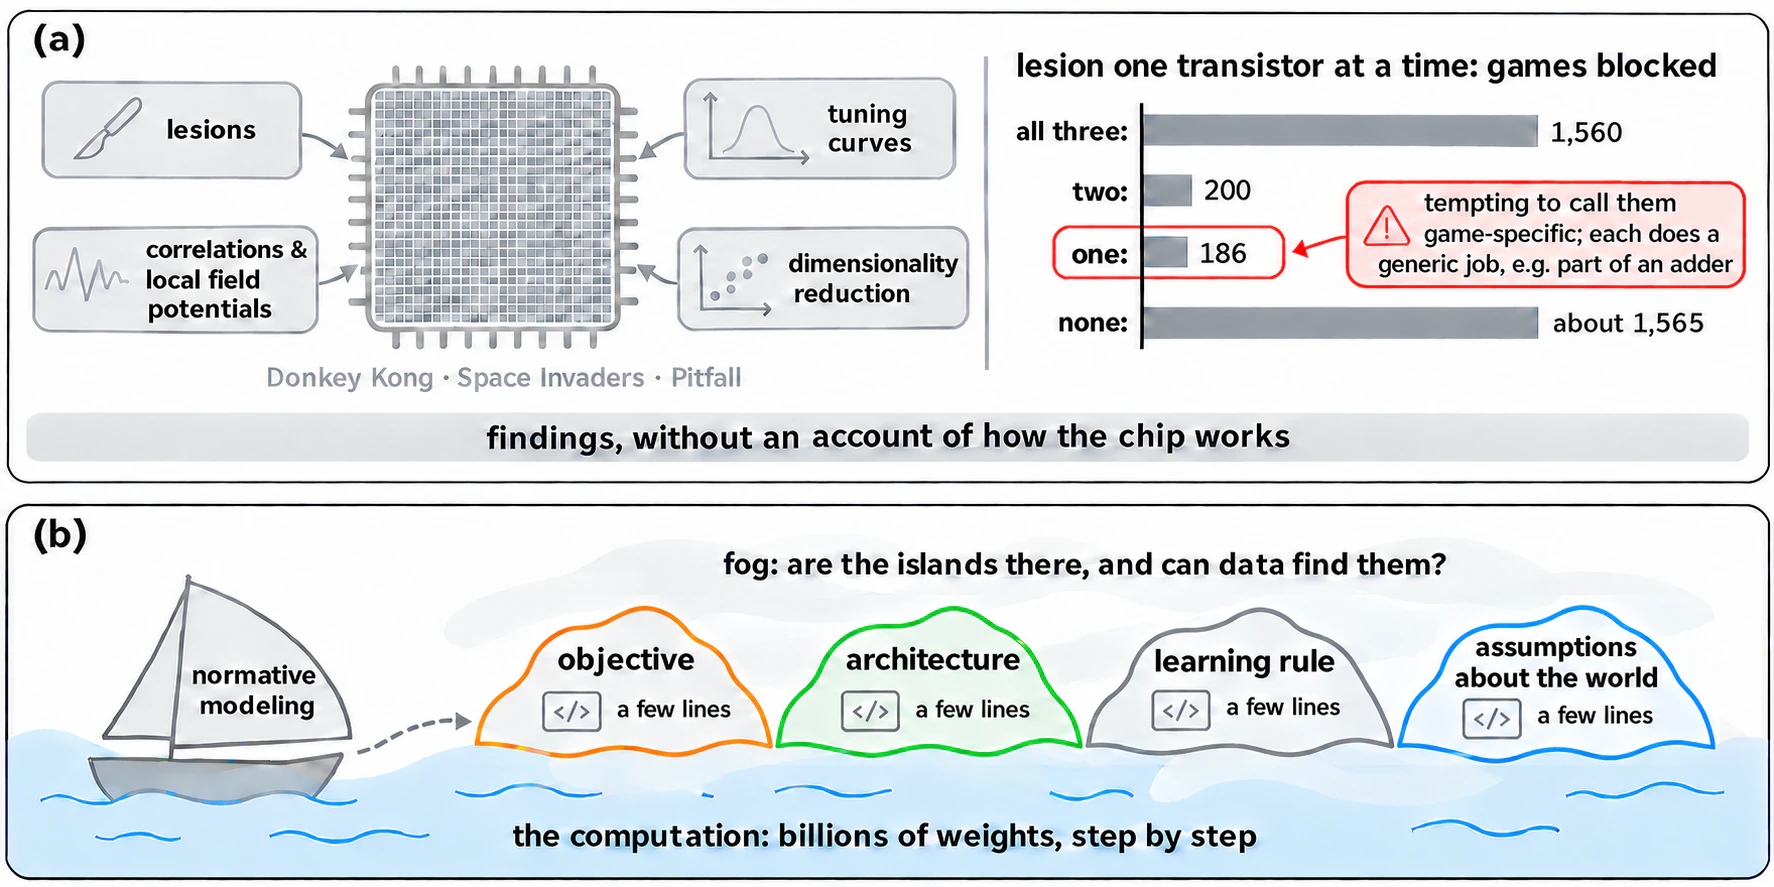
在 “Could a Neuroscientist Understand a Microprocessor?” 一文中[72],两位研究大脑的科学家把分析大脑的标准方法用在一块完全已知的芯片上,看这些方法能否恢复出它的工作原理。他们逐个晶体管地模拟了 MOS 6502,早期家用电脑和游戏机里的那块芯片,把三款游戏 Donkey Kong、Space Invaders 和 Pitfall 当作它的行为,然后依次使用损毁、调谐曲线、相关分析和降维。方法确实产出了发现。逐个损毁 3,510 个晶体管,有 186 个去掉之后恰好有一款游戏不能运行。作者指出,把它们解读为专属于某款游戏的晶体管会严重误导:每一个做的都是通用的活,比如全加器的一部分。其他方法也有收获,降维找到了时钟和读写信号,因果分析找到了寄存器对累加器的影响。但作者的结论是,这些结果离理解处理器的实际工作方式还差得远,没有一项接近工程师会给出的描述:寄存器、指令集、取指和执行的循环。
这个结果有一个更早的先例。神经心理学长期把双重分离当作模块存在的证据:一处损伤伤害功能 A 而不伤 B,另一处伤 B 而不伤 A,就说明 A 和 B 由不同的部件负责。Plaut(1995)[73]训练了一个把拼写映射到语义的网络。网络的结构很简单:一层拼写单元,一层语义单元,中间是全连接的隐层,再加一组帮助语义收敛的清理单元;具体词和抽象词走的是同一条通路,用的是同一批连接,网络里不存在任何一个专门负责其中一类词的部件。训练之后,在不同位置损毁连接,有的网络抽象词受损更重,有的具体词受损更重,双重分离出现了。这里的推论很直接:网络里本来就没有模块,所以双重分离不可能是模块造成的。损伤之所以有选择性,是因为两类词对同一套连接的依赖程度不同,具体词的语义特征更多,对不同类型的损伤有不同的耐受。一处损伤伤了谁,说的是这套连接对各个任务有多要紧,而不是它属于谁。
微处理器上的结果同样不是偶然,一个很简单的推理就能说明它必然出现。把芯片看作一组部件,每款游戏运行时用到其中的一些,而不是全部。只要三款游戏用到的部件不完全重合,就一定有部件只被其中一部分游戏用到;去掉它,只有这几款会坏。那 186 个晶体管,就是其中只被一款游戏用到的。然而“被哪些游戏用到”是这组游戏的性质,不是部件的性质。只有当每种功能只服务于固定的一组任务时,用法标签才和功能标签重合;通用硬件恰恰不是这样:只坏一款游戏的那个晶体管,做的可能是加法器的一部分,只是另外两款游戏的代码恰好不经过它。所以,从损毁某个部件会让哪些功能消失,推不出这个部件就是负责这些功能的模块。
当代的神经网络大模型,某种意义上就是放大版的“微处理器”。每个权重都看得见,每个激活都能记录,每个单元都能损毁,每个实验都能重跑。机制可解释性(mechanistic interpretability)用这种方式找到了真实的结构。一个例子在视觉里。Olah 等人(2020)[74]在一个图像分类网络中找到一个识别汽车的单元,它由上一层的车窗、车身和车轮检测器接成,车窗接在上方,车轮接在下方;Rajaram 等人(2024)[75]把这种寻找自动化了,只给几十张例图就能找出负责一个概念的电路,不仅找回了同一个汽车电路,还在 CLIP 里找到了一个识别文字的电路,剪掉它,模型在“红灯上写着 green”这类文字攻击下的准确率从 3% 升到 87%。另一个例子在语言模型里。归纳头(induction heads)是两个注意力头接成的电路:前一个头把每个词元的前一个词元是什么带到当前位置,后一个头据此在上文里找到当前词元上一次出现的地方,把紧跟在它后面的那个词元提为下一个预测;上文出现过 “A B”,再见到 A 就预测 B。这个电路被认为是上下文学习的主要机制之一[76]。然而,这些发现都在单元和小电路的层面。关于前沿模型为什么给出某个答案,一个更高层、能把许多这样的部件统一起来的解释,机制可解释性至今进展不多。微处理器的结果提示了原因:仅有可及性,并不告诉我们解释该落在哪里。
解释该落在哪里?本文的回答是:落在生成计算的那些东西上。一个智能系统运转时执行的是几十亿个权重上的计算,而生成这些计算的东西很少:目标、架构、学习规则[77],再加上系统对世界结构的几条顶层假设。它们每一样只需几行代码或几行公式就能写下,在计算进行时固定不变,却决定了计算会变成什么样,也能预测训练中从未出现过的条件下的行为;合起来,它们比运转起来的系统小得多。解释一个系统的东西就在这里,不在计算本身。3.1 节说规范建模决定的正是学习时被当作给定的东西,指的就是它们。
说它们是解释,用的是这样一个标准:解释是一个比系统自身小得多、又能预测系统在新条件下行为的描述[58]。一个计算非常稠密的智能系统,它的计算也许根本没有这样的描述。Marr(1977)[78]把这种情形叫作第二类理论:一个问题由许多过程同时作用来解决,而这些过程的相互作用就是它自己最简洁的描述;一个学会识别物体的网络很可能就是这样,训练后的几百万个权重已经是它最简洁的描述[79]。所以要做的是“在计算复杂性的海洋中寻找解释简洁性的岛屿”[58]:海洋是计算本身,岛屿是生成这些计算的规则。对一个具体的复杂系统,这样的岛屿是否存在,是一个经验问题。
认知科学里的层级贝叶斯模型,就是这样解释学习者的。它们问的是人怎样从少量样本学到这么多[80],答案是学习者带着分层的抽象知识:顶层是几条关于世界有什么结构的假设,底层是具体事实,顶层决定了从少量数据里能学出什么。解释一个学习者,靠的是写下它的顶层假设,而不是列举它学到的一切。
即使“岛屿”存在,数据也未必能让我们找到它们:不同的目标可以产生相同的行为(3.3 节),不同的训练历程也可能得到相似的网络。规范建模就是在这层“雾”里研究岛屿的方法:写下一个候选目标,推导它的预测,再在各个候选的预测出现分歧的地方检验它,这就是 3.3 节的第二个条件。
4.2 · AI 比大脑更可及的地方
在 AI 中,这层“雾”要薄一些:产生计算的那些东西里,系统学到的顶层假设和它实际追求的目标仍然要推断(见下面第二点),而训练损失、数据、架构和学习规则是我们自己写下的。3.3 节的第一个条件说的正是这件事。从行为推目标,目标之外的部分,也就是系统面对的环境和它受的约束,不能也从同一批行为里猜出来,否则先验、约束和损失可以相互抵换,推出的目标就不唯一。这些部分要靠别的途径定下,要么单独测量,要么本来就知道。逐项比较大脑和训练好的模型,看这个条件各满足到什么程度。
| 大脑 | 训练好的模型 | |
|---|---|---|
| 环境与数据 | 从生态和实验中推断 | 有记录:训练数据就在硬盘上 |
| 目标 | 靠推断;演化的目标只能靠猜 | 训练损失 $\ell$ 写在代码里 |
| 架构与约束 | 部分已知,难以改变 | 明确设定,可以随意更改 |
| 学习规则 | 大部分未知 | 已知的优化器和已知的学习率调度 |
| 干预 | 有限,常常不可逆 | 重训、消融、扰动、重复 |
| 重复样本 | 每个个体只有一生 | 算力允许多少,就有多少随机种子和变体 |
前四行对应第一个条件,后两行对应第二个:能干预、能重复,才能在不同条件下看行为。右边一列说的是我们自己训练的模型。对别人的闭源模型,数据和训练细节看不到,有几行会退回到左边一列。
由此可以得出三点。第一,规范性解释可以拿真实答案来核对。对大脑,没有人知道真正的目标是什么,推断出的目标只能拿更多的行为去检验,永远对不了答案,所以“隐去真相、只看行为、再看能恢复多少”在神经科学里只能是思想实验。在 AI 里可以真做:训练一族模型,让它们的目标、数据和架构以已知的方式不同,对分析者隐去这些选择,只给行为,看他们能恢复出多少,是目标、先验和约束本身,还是只到一个等价类。代价只是算力。
第二,训练损失是我们写的,训练出来的策略却不一定按它行事。优化器压低的是训练数据上的 $\ell$,这一步没有悬念;可训练结束后拿到的是一个策略,把它放到新条件下,它的行为往往更像在追求另一个目标,那就是 3.1 节的行为目标 $L$。4.4 节会给出一个例子:同一个损失,训练任务的多样性不同,得到的策略像是在用两个不同的先验做贝叶斯估计,在新任务上的表现也完全不同。所以在 AI 里 $L$ 仍然要从行为推断。
第三,3.1 节的那个循环在这里能完整地走完,而且能重复。循环的前半段是训练前按任务要求选损失,后半段是训练后推断系统实际在优化什么,与想要的比较,再回头改。对大脑,后半段只有慢而粗的干预,也不能重来:教育能改目标,改不了架构,更没法把同一个人重训一遍。对训练好的模型,表里的每一行都能改了重训,而且 3.2 节的拆分告诉我们该改哪一行:差距落在约束那一段,就扩大规模;落在其余那一段,就改训练和目标。2.3 节里用金标准奖励检验代理奖励,已经是这个后半段的一个例子。
4.3 · 落地已经开始
近几年已经有不少工作在这样对待 AI 系统:写下系统被训练去解决的问题,推导在这个问题下最好的做法,再拿它和模型的行为比较,只是大多没有用规范建模这个名字。按 3.4 节的三个问题分组。
目标从哪里来?它们如何塑造行为?
- 从训练问题预测失败。 McCoy 等人(2024)[81]主张,理解语言模型要从它被训练去解决的问题入手,也就是在互联网文本上预测下一个词元。由此可以推出:一个对这个问题最优的系统会在意答案的概率,哪怕任务本身是确定性的。预测成立:答案是高概率句子时,GPT-4 正确解码简单移位密码的比例约为 51%,答案是低概率句子时约为 13%;在 rot-13 上准确率陡然升高,而 rot-13 正是网上远比其他移位常见的那一种。这是 3.1 节那个循环的后半段:从训练目标推出行为目标 $L$ 的预测,再在新条件下检验。
- 用目标和约束生成候选解。 为识别物体而训练的网络,其内部表征能预测猴子视觉皮层的反应[82];Richards 等人(2019)[77]把目标、架构和学习规则列为理解大脑的三个要素。箭头是从 AI 指向大脑的,逻辑却是规范性的:定下目标和约束,让优化去找解,再把解与系统比较。
离理想有多近?
- 元学习趋近贝叶斯最优。 在一个任务分布上训练的、基于记忆的元学习器,行为会越来越像针对该分布的贝叶斯最优智能体[83, 84]。这里的理想参照就是 3.2 节的 $\pi_{\text{ideal}}$,训练缩小的正是到它的距离。
- 把上下文学习看作推断。 上下文学习可以解读为隐式的贝叶斯推断[85];被训练在上下文中做线性回归的 transformer,会逼近最优的最小二乘估计量[86]。Raventós 等人(2023)[87]和 Wurgaft 等人(2025)[88]走得最远,理想参照和受限参照都算了出来;4.4 节会详细演算他们的设定。
是系统的性质,还是分析的假象?
- 可识别性有极限。 即使数据无限,奖励学习也只能把奖励恢复到一个等价类,是哪个等价类取决于分析者假设的行为模型[89]。这是 3.3 节的结论在 AI 里的形式:目标之外的部分不先定下,目标就定不下。
- 预测得好,只是世界模型的弱证据。 在行星轨道数据上训练的 transformer 能准确预测轨迹,可当它被调整去预测作用力时,隐含的力的定律与牛顿定律毫无相似之处[90]。干预能给出更强的证据:在一个用黑白棋走法训练的模型里编辑其内部的棋盘状态,它预测的走法会按这次编辑所蕴含的方式改变[91]。前者只在训练条件下检验,后者造出了新条件,差别就是 3.3 节的第二个条件。
- 基准成绩可能掩盖了回放。 在一个标准操作基准上得分超过 90% 的视觉-语言-动作模型,一旦物体、初始状态、指令或环境受到扰动,得分可能跌到接近零[92]:分数有很大一部分来自回放记住的轨迹。基准是任务 $J$ 的代理,这是 2.3 节的差距出现在评估一侧的样子。
3.3 节末尾的提醒在 AI 里同样适用:分析方式本身会制造表象。干预可能把系统推出它的正常工作范围,探针失败可能只是读出方式有问题,同一个表征可以用许多等价的坐标来写。关于模型“拥有”什么的论断,应该和关于大脑拥有什么的论断一样受到审视。
4.4 · 一个完整的例子:上下文学习
线性回归上的上下文学习足够小,第三部分的每个量都能算出来。它也是 4.2 节表格右边一列全部成立的情形:环境、损失、架构、数据都是我们写的,3.3 节的第一个条件直接满足,剩下的只是第二个条件,在不同条件下看行为。设定沿用 Raventós 等人(2023)[87]。一个任务是一个向量 $w \in \mathbb{R}^D$。输入为 $x_k \sim \mathcal{N}(0, I_D)$,目标为 $y_k = w^{\top} x_k + \varepsilon_k$,其中 $\varepsilon_k \sim \mathcal{N}(0, \sigma^2)$。一个 transformer 读入 $(x_1, y_1, \dots, x_{k-1}, y_{k-1}, x_k)$ 并预测 $y_k$,用平方误差训练。预训练时,任务从一个由 $M$ 个向量组成的固定集合 $\{w^{(1)}, \dots, w^{(M)}\}$ 中均匀抽取,每个向量都事先从 $\mathcal{N}(0, I_D)$ 中采样一次。测试时,任务是从 $\mathcal{N}(0, I_D)$ 中新抽取的。
有两个自然的参照,都是 3.2 节意义上的理想参照:只受上下文里的信息限制,不受容量限制,但对应两个不同的环境。第一个对预训练世界最优,即在它见过的 $M$ 个任务上取均匀先验。它的估计是这些任务的后验加权平均:
$$\hat{w}^{\text{dMMSE}}_k \;=\; \sum_{i=1}^{M} \frac{\exp\!\Big(-\frac{1}{2\sigma^2} \sum_{j<k} \big(y_j - w^{(i)\top} x_j\big)^2\Big)}{\sum_{i'=1}^{M} \exp\!\Big(-\frac{1}{2\sigma^2} \sum_{j<k} \big(y_j - w^{(i')\top} x_j\big)^2\Big)}\; w^{(i)}.$$
第二个对任务所采样自的高斯世界最优,由此得到岭回归,惩罚系数由噪声决定:
$$\hat{w}^{\text{ridge}}_k \;=\; \big(X^{\top} X + \sigma^2 I_D\big)^{-1} X^{\top} y,$$
其中 $X$ 和 $y$ 由前 $k-1$ 个样本堆叠而成。
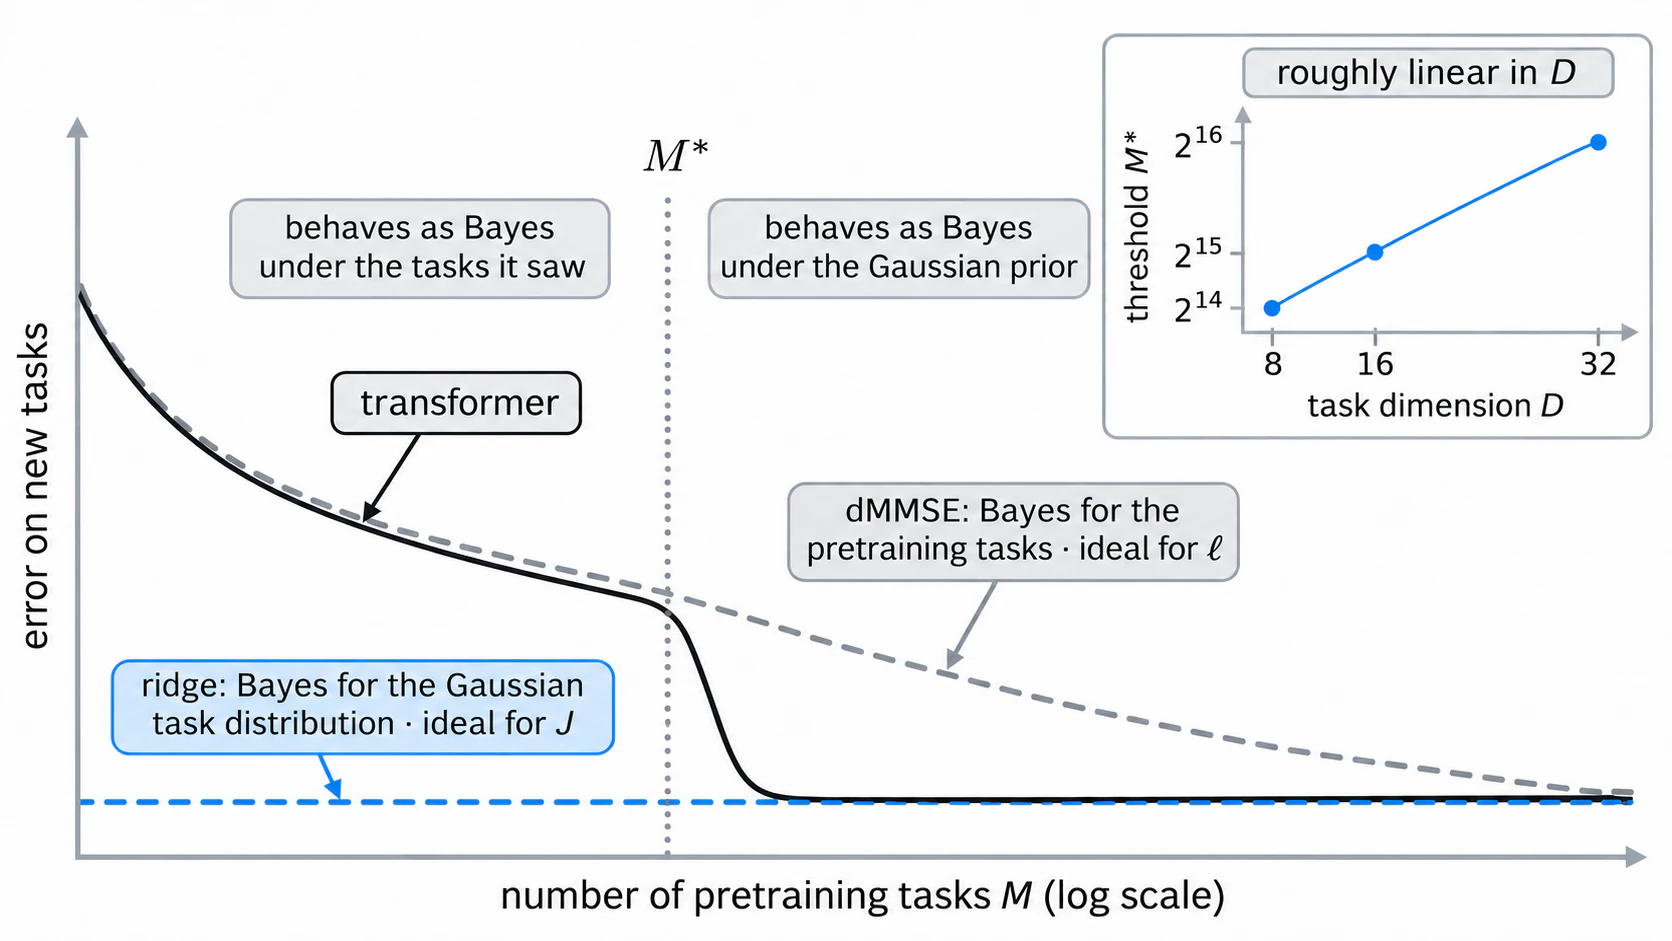
Raventós 等人发现了一个任务多样性的阈值。预训练任务少时,transformer 的行为像 dMMSE:对见过的任务接近最优,对新任务表现很差。越过阈值后,它的行为像岭回归,能泛化到没见过的任务上,而这要求它偏离针对自身预训练分布的贝叶斯最优估计量。阈值大致随维度线性增长:$D = 8$、$16$、$32$ 时,分别约为 $2^{14}$、$2^{15}$ 和 $2^{16}$ 个任务。
现在把三个问题过一遍。
行为反映的是什么目标? 3.1 节的三样东西在这里都写得出来。训练损失 $\ell$ 在阈值两侧相同:对下一个目标值的平方误差,定义在 $M$ 个预训练任务上。任务评估 $J$ 是在高斯世界的新任务上的预测误差。行为目标 $L$ 则不同:在阈值左侧,模型的行为像离散先验下的贝叶斯估计;在右侧,像高斯先验下的贝叶斯估计。损失相同,目标不同,决定是哪一个的是数据。
理想、受限、实际? 首先,哪个理想?$\ell$ 定义在 $M$ 个任务上,它的理想是 dMMSE;$J$ 定义在高斯世界上,它的理想是岭回归。阈值以下的模型离 $\ell$ 的理想很近,离 $J$ 的理想很远:第二部分讲的 $J$ 与 $\ell$ 的差距,在这里能算出来。以岭回归为参照,这段差距随 $M$ 增大按预测缩小,所以 $M$ 通过了 3.2 节对约束的检验,可以算进 $\Delta_1$:能改变它,差距随之移动。这段差距是数据的代价,该改的是表里数据那一行。阈值以上的模型给出一个方向相反的差距:在预训练环境下以 dMMSE 为参照量,它的风险更高,$\Delta_2 > 0$,而这正是我们想要的差距,因为它换来的是 $J$ 上的泛化。差距的正负和意义取决于在哪个环境、哪个损失下量,三个策略不共享同一个环境时,$\Delta_2$ 没有固定的意义,3.2 节那个条件就是为此而设。它也印证 4.2 节的第二点:优化器压低的是 $\ell$,训练出的策略不一定按它行事,而且在这里不按它行事更好。至于受限参照,Wurgaft 等人(2025)[88]把候选策略当作贝叶斯预测器,并给复杂度标上价格。由此得到的拟合与复杂度之间的权衡,能预测模型在训练中何时切换策略;模型转向记忆所需的时间,则随任务多样性超线性增长。这就是 3.2 节意义上的受限参照,一旦复杂度有代价,所能得到的最好的预测器;而复杂度的价格也通过了和 $M$ 一样的检验:它不是自由参数,因为它预测了切换的时机,时机又随任务多样性按预测移动。
性质还是假象? 在这个设定里,4.2 节第一点说的那种对答案的检验成本最低。在 $M$、$D$ 和训练时长构成的网格上训练模型,隐去网格,只给分析者每个模型在探测序列上的预测,问它看起来在用哪个先验、阈值在哪里。然后在留出的条件下检验这些回答:新任务、更长的上下文、偏移的输入分布。我很想看到有人系统地做这件事,因为它能告诉我们:在答案已知时,单凭行为能走多远。
前沿模型难,难在一个明确的地方:第一个条件退化了。别人的模型,数据看不到,环境和先验要靠猜,参照算不出来。规范建模在那里从“算出参照来比”退成“生成假说,再用干预检验”。逻辑不变,变的是能确定多少。
4.5 · 可能的不同意见
下面三条意见有一个共同的答案:规范建模管的是方法之前的事(3.1 节),也就是方法该朝哪个目标、在什么约束下工作、拿什么检验。所以它和这些方法并不竞争。
“这不就是贝叶斯建模吗?” 规范模型常常是贝叶斯的,但按完全类定理[4],几乎任何合理的行为对某个先验和损失都是贝叶斯最优的。规范模型的内容不在这个标签,而在它定下了哪个环境、哪些约束、哪个损失,以及用哪个新条件来检验。
“为什么不直接做机制可解释性?” 机制说明一项计算是怎样执行的,规范性解释说明为什么是这项计算。按 Marr 的层次,前者在算法层和实现层,后者在计算层,回答的不是同一个问题。两者也互相需要:知道一个电路是为了什么,才找得到它、叫得出名字(4.1 节);关于内部目标的论断,最终要拿机制来核对。
“苦涩的教训不是说,别把人的分析放进去吗?” Sutton(2019)[93]强调的是不要把人类知识写进系统的算法,要用能随算力扩展的通用方法去搜索、去学习。规范建模处理的正是教训没有触及的部分:系统该朝什么目标去搜索和学习。单纯扩大算力和数据的规模也是一样:规模缩小的是差距中由约束造成的那一段 $\Delta_1$(3.2 节),缩不小 $\Delta_2$;行为目标与我们想要的不同时,更多的优化只会把差距推得更大(图 7)。规模看起来够用,一部分原因是人在向系统适应(5.2 节)。
第五部分 · 会演化的目标
到目前为止,目标出现在两个位置上:造系统时由我们选定,解释系统时由我们推断。改目标的也是人,在两次训练之间。在现在正被构建的系统中,这一步开始交给系统自己:奖励模型被重新训练,评判者被替换,智能体为其他智能体编写奖励。最后这一部分要问:对于会演化的目标,规范建模能说些什么?
5.1 · 智能系统演化中有层次的回路
一个学习系统里的任何更新,都是在别的东西固定不变时进行的。梯度步改参数时,损失、数据和架构不动;要判断一个损失好不好,得在它之下把参数训练一遍,看结果;要判断一个架构,得训练它,也许还要换几个损失训练。于是更新之间有一个顺序:一样东西只有在为它固定不变的那些东西都跑过一遍之后,才能被评判。按这个顺序,更新套成一层一层的回路,外层的一个样本要花掉内层完整跑一遍的代价。只要系统是靠结果来改自己的,这个嵌套就在,好几个学科分别发现过它:Ashby(1952)[94]的超稳定系统用一条慢回路监视快回路,只在快回路守不住关键变量时才改它的参数;超参数优化和元学习把同一结构写成双层优化,外层的目标由内层问题的解来定义;层级贝叶斯模型里,超先验要从许多任务学,每个任务只给它一个样本[95];大脑里,多巴胺驱动的慢学习训练出前额叶内部的快学习[96]。
分几层是选择。Simon(1962)[97]指出,复杂系统几乎都是近可分解的,部件内部的相互作用强、部件之间弱,所以不同的规律在不同的时间尺度上变化;一个量应当在它变化的尺度上被更新,世界有几个可分的尺度,就值得分几层。本文分三层,因为按“谁来改”,3.1 节的四个部分分成三组:策略,也就是权重,由训练在损失给定下求解;损失与准则,也就是目标,今天由后训练、奖励建模和研究者在两次训练之间的手工活来改,这是 3.1 节那个循环的后半段;世界与策略类,也就是数据和架构,由架构搜索和领域对下一步预训练什么的决定来改。在动物身上,三层大致对应一生中的学习、发育尺度上的驱力调整和演化。合并或细分都可以,不变的只有顺序。这些层和 Marr 的层次不是一回事:Marr 的是同一时刻对同一计算的三种描述,这里的是谁为谁固定不变。
顺序决定了证据。越靠外的回路,一个样本越贵,样本就越少、噪声越大,每一次更新应当要求的证据也越强。对大脑这是极端情形:一生只给一套驱力一个样本,一个物种只给架构一个样本。今天的机器学习大多活在最内层,外两层仍主要由人来跑。从这里拿走的是一个问题:每一类更新,应当要求多少证据?
样本少,却不一定学得慢。统计学里诅咒多于祝福:维数灾难说的是同一层里参数越多、样本越不够用[23],5.3 节还会遇到优化者诅咒。跨层却有一个反方向的结果,叫抽象的祝福[98]:顶层的抽象知识可以比底层的具体知识学得更快,因为顶层的假设本来就少,而底下每一个具体任务都给它提供一条证据。孩子先学会“按形状分类”这条规则,再学会每一类的形状,就是这样[95]。放到回路上说,外层的样本确实少,但外层要定的东西也少而抽象,4.1 节的岛屿之所以可能被找到,这是原因之一。所以外层回路真正的难处不在样本的数目,而在样本是否独立于它要评判的东西,这是 5.3 节的主题。
自动化让证据的问题变得紧迫。第二部分讲过,损失看起来像建模的全部,是因为损失之后的那一步被自动化了,其余部分被默认值填上;同样的压力如今正在向外推进。语言模型以代码形式为机器人编写奖励函数[99],架构搜索和自动化研究也在把最慢的那层回路推向机器。每一步都让外层更新变得更便宜,却没有缓解每次更新所需证据的稀缺。外层回路越快,就意味着有越多的更新要用同一批评估来评判,也就有越多机会去拟合评估本身,2.3 节的奖励黑客就搬到了外层回路。
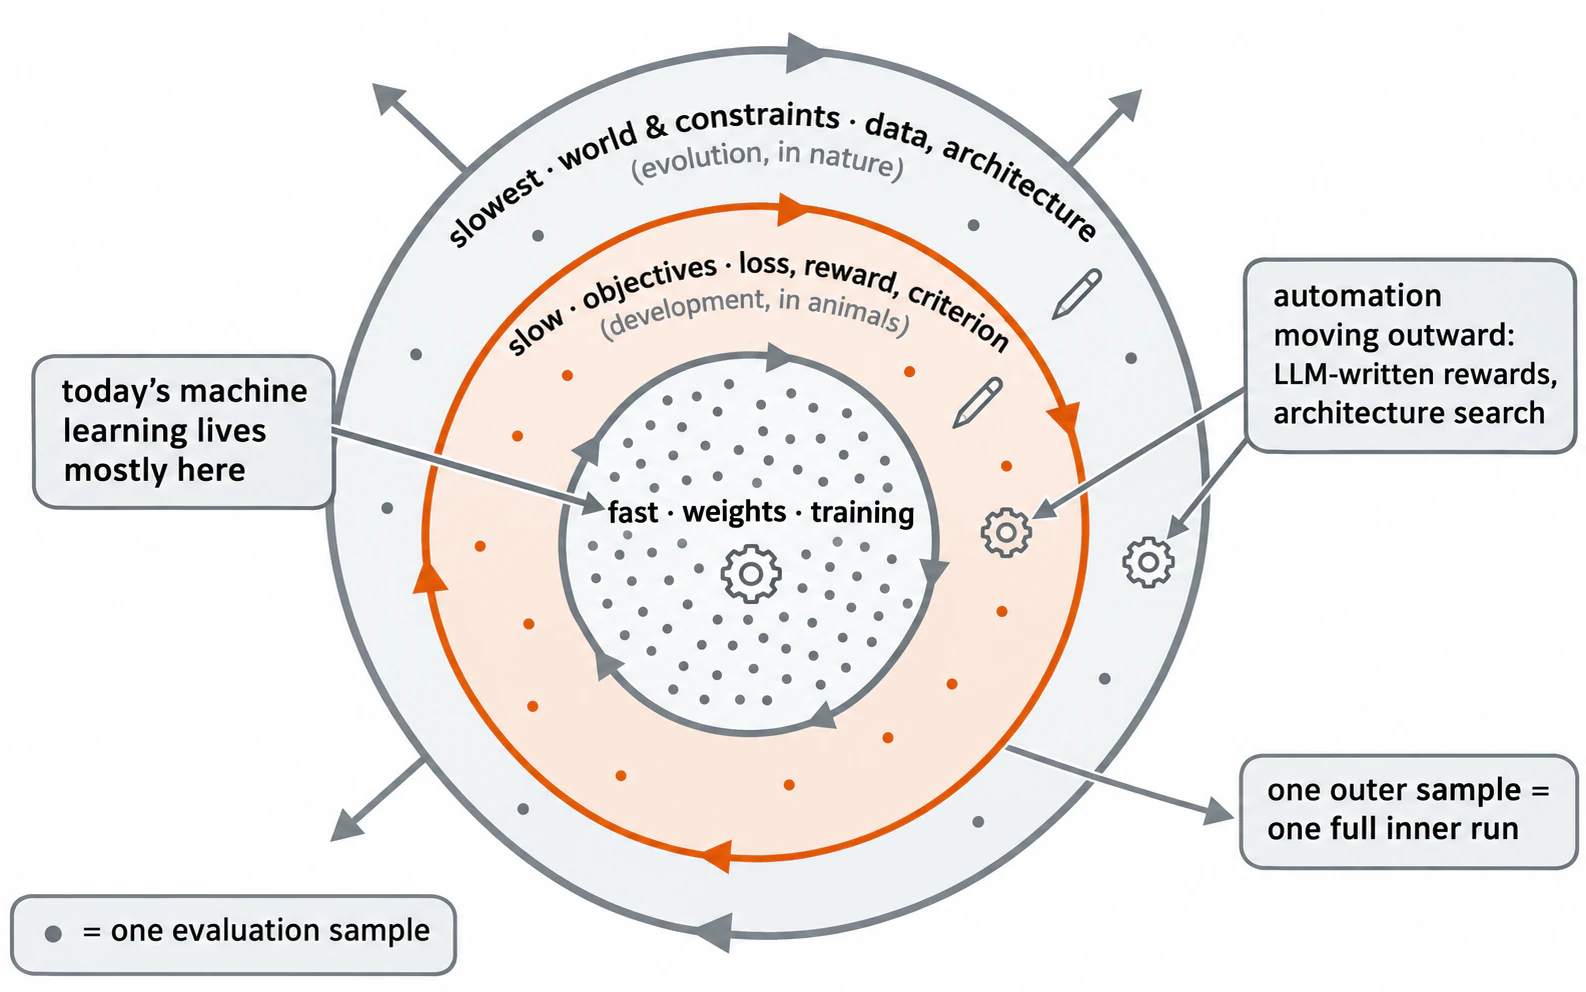
5.2 · 好的演化与坏的演化
目标会变,变得好不好,只能以结果论:环境变了之后,系统在我们关心的任务上是更好了还是更差了。按这个标准,好的演化有几个特征:目标随环境改变而改变,每一次改变都在下一次开始前经过核验,而核验所依据的东西是系统自己影响不了的。坏的演化则相反:目标贴合了一个已经偏离任务的环境,核验所依据的正是系统能够影响的东西,于是指标还在改善,任务已经不再被服务。两者的差别不在优化得多卖力,在于改目标时依据的是什么证据。
自然界里两种都有。五亿多年前,奇虾(Anomalocaris)是寒武纪海洋的顶级掠食者[100],带刺的前附肢是为抓捕软体猎物而生的[101]。随后的数千万年里,猎物长出硬壳、钻进沉积物,浮游生物极大地多样化,捕食型的放射齿类从化石记录中消失;它们的滤食型近亲改了食性,延续下来,体长超过两米的 Aegirocassis 就是其中之一[102, 103]。化石记录只支持把这当作一种解读,但作为故事它很贴切:一边守着为正在消逝的世界量身定做的目标,一边随环境改了目标。
前沿模型这几年的积累,走的是好的那条路。它们先在答案可以核验的领域立住:代码要么能跑、要么不能,证明要么成立、要么不成立。然后把每个掌握了的领域变成通往下一个领域的工具:代码用来写奖励和搭环境,仿真用来为物理世界做训练,到 2026 年,通用模型已经能直接根据相机画面控制机械臂,在简单的抓取放置上表现可靠,在精细操作上仍然吃力[104, 105]。每一级在下一级开始前经过核验,而核验者,编译器、证明检查器、物理世界,不受模型影响。
同样的模型也可能变成奇虾。对着基准训练的模型,学会的是基准;由测试给奖励的智能体,可能学会以谁都没想到的方式满足测试[49];在自己的输出上反复训练的模型,会丢掉起初那个分布的尾部[106]。每一种情况,目标都贴合了一个环境,而这个环境已经偏离了我们关心的那个:训练损失 $\ell$ 还在改善,任务 $J$ 已经不再被服务。差别就在核验者:基准、测试和模型自己的输出,都是模型能够影响的东西。
环境会变,而环境里包括我们自己。生物学把这叫生态位建构(niche construction):生物改造环境,再被自己改造过的环境选择[107]。门的尺寸、路的宽度、文字、社会习惯,都是人建构的生态位,对任务未必最优,但一旦建成,后来者就得适应它。人形机器人就是这个逻辑的推论:抽象地问做事的最优形态,答案多半不是人形;可环境已经被人的身体塑造过,把门把手、楼梯和工具写进约束,受限最优就偏向人形。同样的事也发生在我们和模型之间,只是方向相反:我们改提示词、改工作流程、改基准,去迁就模型擅长的事。差距于是从两头合拢,训练让 $L$ 向 $J$ 移动,适应让 $J$ 向 $L$ 移动。所以判断目标是否该改时,要分清环境是真的变了,还是我们自己迁就了系统。
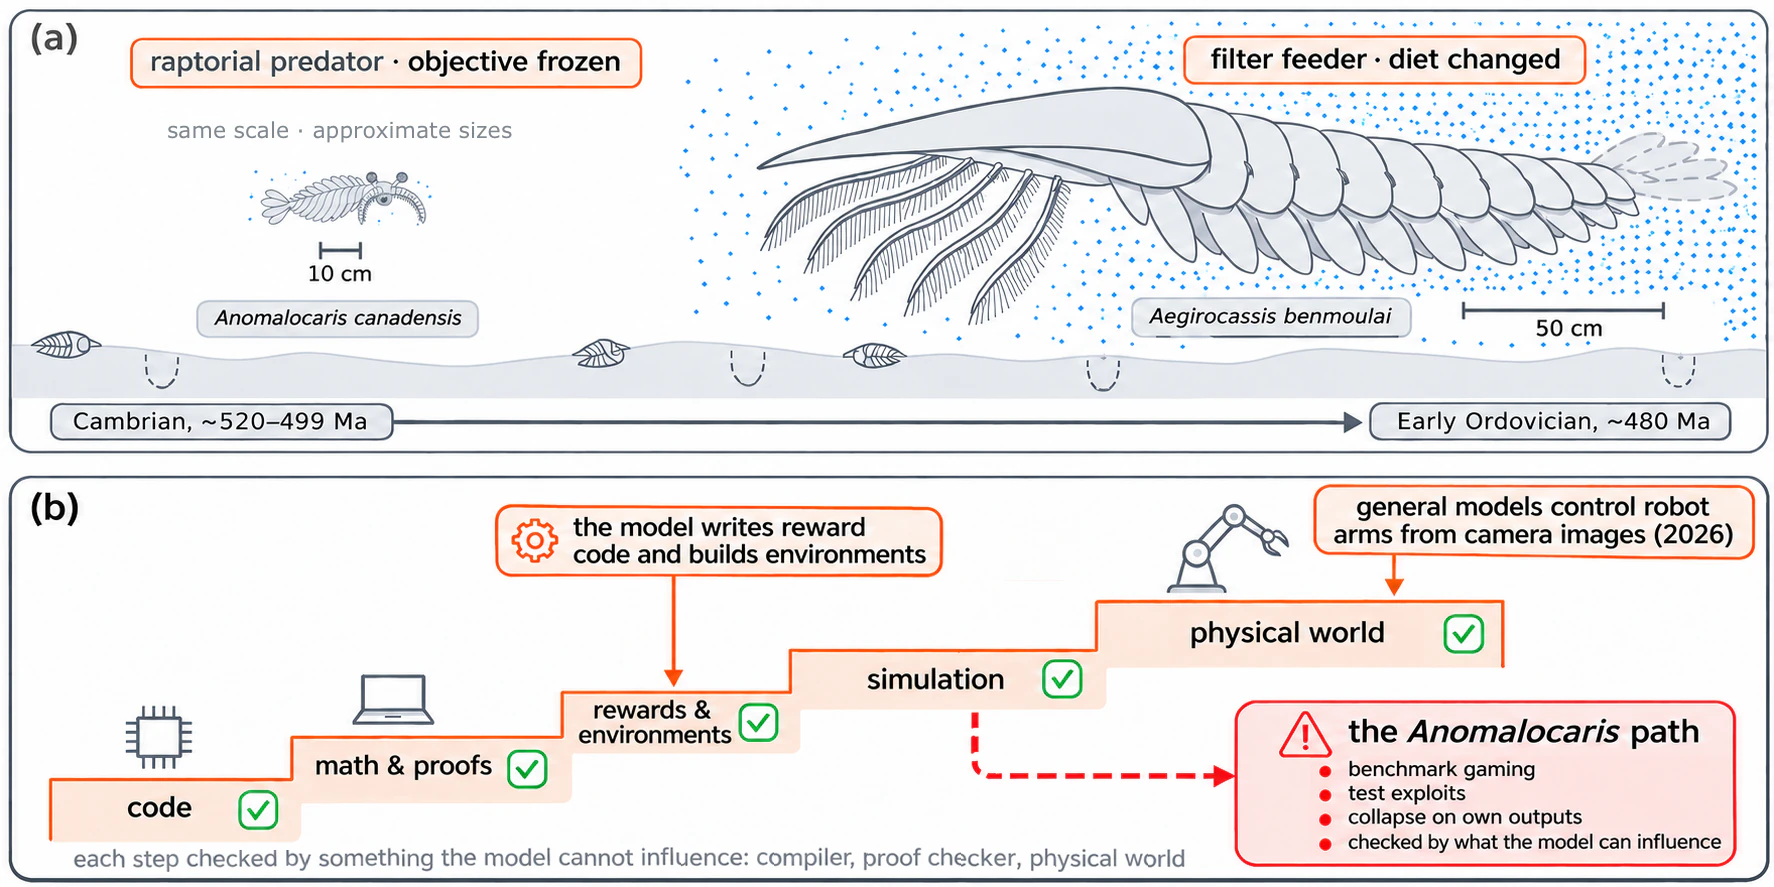
5.3 · 目标何时应当改变?
由此引出三个问题,规范建模为每一个都提供了抓手。
何时。 当在某个目标下最优的行为不再服务于任务时,这个目标就过时了。用 3.1 节的记号说,就是 $J$ 与 $\ell$ 之间的差距拉开了,而拉开有两个来源。一是世界动了:$J$ 变了,$\ell$ 没变,对 $\ell$ 最优的行为不再服务于 $J$。奇虾就是这种,目标曾经是对的。二是系统动了:$J$ 和 $\ell$ 都没变,优化把策略推进了两者分叉的区域。图 7 的曲线和对着基准训练都是这种,这是外层回路对评估的过拟合。症状一样,补救不一样:前一种要改 $\ell$ 去追 $J$;后一种不该改 $\ell$,该换核验者,或者少优化一点。5.2 节还给出第三种:$J$ 向 $L$ 移动了,是我们迁就了系统,这时先要确认 $J$ 有没有真的变。前文介绍过的三个征兆可以帮着分辨:代理指标持续改善而独立评估停滞或下降(图 7),是第二种;放松约束之后差距没有缩小,落在 $\Delta_2$,说明问题在训练或目标本身,不在约束(3.2 节);预测在训练条件下成立、在新条件下失效(4.3 节),是第一种。
一个自己改目标的系统,把“何时”变成了另一个问题。它判断目标是否过时,依据的是它自己算出来的评估,而这个评估是它能影响的东西:想改目标,就能让评估显示目标过时了。所以对它来说,过时与否不能由自己的训练信号判定,只能由它碰不到的 $J$ 判定。风险的方向也反过来:人跑外层回路时,危险是目标改得太慢;系统自己跑时,危险是改得太容易。
多快。 外层的样本少,但 5.1 节说过,这不是主要的约束。那里的原则是,一个量应当在它变化的尺度上被更新。目标的真值变化的尺度,就是 $J$ 变化的尺度,所以改目标有两个上限:不快于 $J$ 实际变化的速度,也不快于独立证据到达的速度。自动化降低的是提出改变的成本,这两个上限它都没有动。第二个上限可以算:用同一个评估比较 $K$ 个候选,胜者的分数平均虚高约 $\sigma\sqrt{2\ln K}$,候选越多、评估越少,虚高越大,这就是优化者诅咒[108]。自适应地反复使用留出集,会破坏它的有效性;Dwork 等人(2015)[109]的可复用留出集能限制这种损害:除非留出集与训练集的结果相差超过一个加了噪声的阈值,它都只用训练集的结果作答,因此每次查询泄露的留出集信息很少。一个修订自身目标的系统,就是它自己评估的自适应分析者,两个问题它都会继承。
依据什么证据。 依据系统影响不了的证据,这是 5.2 节区分好坏演化的那条标准。它的根据在 5.1 节的结构里:评判一层的东西,不能来自这一层自己,Ashby 把关键变量放在快回路之外就是这个意思;3.3 节对分析者提的第一个条件,是同一件事的另一面。核验者按独立程度可以排序:物理世界、编译器和证明检查器最硬;留出的人类评估居中,而且每用一次独立性就降一点,这正是可复用留出集要管的事;基准和模型自己的输出最软,因为模型能影响它们。在实践中,这意味着要明确哪些评估用来提出改变、哪些用来检验,系统能碰到流程中的哪些部分,什么时候需要外部核查。还有一个结构上的事实:没有哪个证据是绝对独立的,只有比被评判的那一层高一层的证据。最外层回路的核验者,外面没有别的层了,只有我们。所以系统对外部纠正保持开放,不是一种美德,是最外层回路的结构要求;评估者也会出错这件事,只是让这个要求更紧。
5.4 · 还没有答案的问题
Wald 点出了两项数学替你做不了的选择:损失,以及如何对未知的部分进行汇总。此后八十多年的大部分时间里,这两项选择由人来做,其余的交给数学。深度学习把损失选定之后的求解交给了机器,又把问题的很大一部分设成了默认值。规范建模在知觉与动作研究中成长起来,它把同样的选择当作关于一个系统的假说,并加以检验。
AI 系统从内部越来越难解释;它们正开始自己做这些选择,而这些选择对不对,不能由它们自己能影响的证据来判定;同时,它们的目标、数据和架构又几乎完全在我们手里。这正是我认为规范建模应该在 AI 中落地的原因。这门学问要问的是:一个系统在优化什么,这离它能达到的程度有多远,以及我们的答案描述的是系统本身,还是我们的方法。同样的三个问题,造系统时也要问。长远的目标,是一个能察觉自身目标何时过时、并依据自己无法操纵的证据加以修订,同时对外部纠正保持开放的系统。
我最想看到答案的几个问题:
- 单凭行为能恢复出多少? 在目标、数据和架构已知但对分析者隐藏时,分析者能识别出一个系统的目标、先验和约束中的哪些部分,哪些部分只能识别到一个等价类?
- 哪些差距是规模能弥合的? 相对于理想参照和受限参照给差距定位,能否预测哪种干预有效:更大的容量、不同的数据,还是不同的目标?
- 诊断能迁移吗? 在一种条件下做出的诊断,能否预测一项干预在另一种条件下的效果?还是每个新条件都需要一个新模型?
- 一个系统能不能可信地判断自己的目标过时了? 当它能影响自己的评估时,目标应该以多快的速度、依据什么证据来改变?
引用格式:
Zhang, Xiao. (Nov 2026). Where objectives come from: Why AI needs normative modeling. xzhang.art. https://xzhang.art/NLF/
1 | @article{zhang2026objectives, |
参考文献
参考文献保留英文原文。
- Neyman, J., and E. S. Pearson. “On the problem of the most efficient tests of statistical hypotheses.” Philosophical Transactions of the Royal Society A, 1933. doi:10.1098/rsta.1933.0009
- Wald, A. “Contributions to the theory of statistical estimation and testing hypotheses.” Annals of Mathematical Statistics, 1939. doi:10.1214/aoms/1177732144
- Wald, A. “Statistical decision functions which minimize the maximum risk.” Annals of Mathematics, 1945. doi:10.2307/1969022
- Wald, A. Statistical Decision Functions. Wiley, 1950.
- Wald, A. “Sequential tests of statistical hypotheses.” Annals of Mathematical Statistics, 1945. doi:10.1214/aoms/1177731118
- Wald, A. Sequential Analysis. Wiley, 1947.
- Wald, A., and J. Wolfowitz. “Optimum character of the sequential probability ratio test.” Annals of Mathematical Statistics, 1948. doi:10.1214/aoms/1177730197
- Arrow, K. J., D. Blackwell, and M. A. Girshick. “Bayes and minimax solutions of sequential decision problems.” Econometrica, 1949. doi:10.2307/1905525
- Casselman, B. “The legend of Abraham Wald.” AMS Feature Column, June 2016. Link
- Wald, A. “A method of estimating plane vulnerability based on damage of survivors.” Statistical Research Group, Columbia University, 1943. Reprinted as CNA Research Contribution 432, Center for Naval Analyses, 1980. DTIC ADA091073
- Mangel, M., and F. J. Samaniego. “Abraham Wald’s work on aircraft survivability.” Journal of the American Statistical Association, 1984. doi:10.1080/01621459.1984.10478038
- Peterson, W. W., T. G. Birdsall, and W. C. Fox. “The theory of signal detectability.” Transactions of the IRE Professional Group on Information Theory, 1954. doi:10.1109/TIT.1954.1057460
- Tanner, W. P., and J. A. Swets. “A decision-making theory of visual detection.” Psychological Review, 1954. doi:10.1037/h0058700
- Green, D. M., and J. A. Swets. Signal Detection Theory and Psychophysics. Wiley, 1966.
- Tanner, W. P., and T. G. Birdsall. “Definitions of d′ and η as psychophysical measures.” Journal of the Acoustical Society of America, 1958. doi:10.1121/1.1909408
- Harris, C. M., and D. M. Wolpert. “Signal-dependent noise determines motor planning.” Nature, 1998. doi:10.1038/29528
- Todorov, E., and M. I. Jordan. “Optimal feedback control as a theory of motor coordination.” Nature Neuroscience, 2002. doi:10.1038/nn963
- Trommershäuser, J., L. T. Maloney, and M. S. Landy. “Statistical decision theory and the selection of rapid, goal-directed movements.” Journal of the Optical Society of America A, 2003. doi:10.1364/JOSAA.20.001419
- Körding, K. P., and D. M. Wolpert. “Bayesian integration in sensorimotor learning.” Nature, 2004. doi:10.1038/nature02169
- Ratcliff, R. “A theory of memory retrieval.” Psychological Review, 1978. doi:10.1037/0033-295X.85.2.59
- Bogacz, R., E. Brown, J. Moehlis, P. Holmes, and J. D. Cohen. “The physics of optimal decision making: A formal analysis of models of performance in two-alternative forced-choice tasks.” Psychological Review, 2006. doi:10.1037/0033-295X.113.4.700
- Gold, J. I., and M. N. Shadlen. “The neural basis of decision making.” Annual Review of Neuroscience, 2007. doi:10.1146/annurev.neuro.29.051605.113038
- Bellman, R. Dynamic Programming. Princeton University Press, 1957.
- Howard, R. A. Dynamic Programming and Markov Processes. Technology Press of MIT and Wiley, 1960.
- Åström, K. J. “Optimal control of Markov processes with incomplete state information.” Journal of Mathematical Analysis and Applications, 1965. doi:10.1016/0022-247X(65)90154-X
- Sutton, R. S., and A. G. Barto. Reinforcement Learning: An Introduction, 2nd ed. MIT Press, 2018. Link
- Schultz, W., P. Dayan, and P. R. Montague. “A neural substrate of prediction and reward.” Science, 1997. doi:10.1126/science.275.5306.1593
- Chow, C. K. “An optimum character recognition system using decision functions.” IRE Transactions on Electronic Computers, 1957. doi:10.1109/TEC.1957.5222035
- Chow, C. K. “On optimum recognition error and reject tradeoff.” IEEE Transactions on Information Theory, 1970. doi:10.1109/TIT.1970.1054406
- Duda, R. O., and P. E. Hart. Pattern Classification and Scene Analysis. Wiley, 1973.
- Vapnik, V. N. Statistical Learning Theory. Wiley, 1998.
- Russell, S., and P. Norvig. Artificial Intelligence: A Modern Approach. Prentice Hall, 1995.
- Russell, S., and D. Subramanian. “Provably bounded-optimal agents.” Journal of Artificial Intelligence Research, 1995. doi:10.1613/jair.133
- Griffiths, T. L., F. Lieder, and N. D. Goodman. “Rational use of cognitive resources: Levels of analysis between the computational and the algorithmic.” Topics in Cognitive Science, 2015. doi:10.1111/tops.12142
- Lieder, F., and T. L. Griffiths. “Resource-rational analysis: Understanding human cognition as the optimal use of limited computational resources.” Behavioral and Brain Sciences, 2020. doi:10.1017/S0140525X1900061X
- Torralba, A., and A. A. Efros. “Unbiased look at dataset bias.” CVPR, 2011. doi:10.1109/CVPR.2011.5995347
- Geifman, Y., and R. El-Yaniv. “Selective classification for deep neural networks.” NeurIPS, 2017. arXiv:1705.08500
- Madras, D., T. Pitassi, and R. Zemel. “Predict responsibly: Improving fairness and accuracy by learning to defer.” NeurIPS, 2018. arXiv:1711.06664
- Russakovsky, O., et al. “ImageNet large scale visual recognition challenge.” International Journal of Computer Vision, 2015. doi:10.1007/s11263-015-0816-y
- Deng, J., J. Krause, A. C. Berg, and L. Fei-Fei. “Hedging your bets: Optimizing accuracy-specificity trade-offs in large scale visual recognition.” CVPR, 2012. doi:10.1109/CVPR.2012.6248086
- Bertinetto, L., R. Mueller, K. Tertikas, S. Samangooei, and N. A. Lord. “Making better mistakes: Leveraging class hierarchies with deep networks.” CVPR, 2020. doi:10.1109/CVPR42600.2020.01252
- Sagawa, S., P. W. Koh, T. B. Hashimoto, and P. Liang. “Distributionally robust neural networks for group shifts: On the importance of regularization for worst-case generalization.” ICLR, 2020. arXiv:1911.08731
- Gneiting, T., and A. E. Raftery. “Strictly proper scoring rules, prediction, and estimation.” Journal of the American Statistical Association, 2007. doi:10.1198/016214506000001437
- Bishop, C. M. Pattern Recognition and Machine Learning. Springer, 2006.
- Guo, C., G. Pleiss, Y. Sun, and K. Q. Weinberger. “On calibration of modern neural networks.” ICML, 2017. arXiv:1706.04599
- Elkan, C. “The foundations of cost-sensitive learning.” IJCAI, 2001.
- Elmachtoub, A. N., and P. Grigas. “Smart ‘predict, then optimize’.” Management Science, 2022. doi:10.1287/mnsc.2020.3922
- Ouyang, L., et al. “Training language models to follow instructions with human feedback.” NeurIPS, 2022. arXiv:2203.02155
- Krakovna, V., et al. “Specification gaming: The flip side of AI ingenuity.” DeepMind blog, April 21, 2020. Link
- Gao, L., J. Schulman, and J. Hilton. “Scaling laws for reward model overoptimization.” ICML, 2023. arXiv:2210.10760
- Manheim, D., and S. Garrabrant. “Categorizing variants of Goodhart’s law.” arXiv, 2018. arXiv:1803.04585
- Bradley, R. A., and M. E. Terry. “Rank analysis of incomplete block designs: I. The method of paired comparisons.” Biometrika, 1952. doi:10.2307/2334029
- Luce, R. D. Individual Choice Behavior: A Theoretical Analysis. Wiley, 1959.
- Christiano, P., J. Leike, T. B. Brown, M. Martic, S. Legg, and D. Amodei. “Deep reinforcement learning from human preferences.” NeurIPS, 2017. arXiv:1706.03741
- Ziegler, D. M., et al. “Fine-tuning language models from human preferences.” arXiv, 2019. arXiv:1909.08593
- Ortega, P. A., and D. A. Braun. “Thermodynamics as a theory of decision-making with information-processing costs.” Proceedings of the Royal Society A, 2013. doi:10.1098/rspa.2012.0683
- Rafailov, R., A. Sharma, E. Mitchell, C. D. Manning, S. Ermon, and C. Finn. “Direct preference optimization: Your language model is secretly a reward model.” NeurIPS, 2023. arXiv:2305.18290
- Kording, K. “Why we systems neuroscientists should (usually) be quietists: The philosophical logic of NeuroAI.” Substack, October 19, 2026. Link
- Marr, D. Vision: A Computational Investigation into the Human Representation and Processing of Visual Information. W. H. Freeman, 1982.
- Anderson, J. R. The Adaptive Character of Thought. Lawrence Erlbaum Associates, 1990.
- Kording, K. “The simple conceptual logic of normative models of behavior.” Substack, March 17, 2025. Link
- Körding, K. P., and D. M. Wolpert. “The loss function of sensorimotor learning.” Proceedings of the National Academy of Sciences, 2004. doi:10.1073/pnas.0308394101
- Hubinger, E., C. van Merwijk, V. Mikulik, J. Skalse, and S. Garrabrant. “Risks from learned optimization in advanced machine learning systems.” arXiv, 2019. arXiv:1906.01820
- Lewis, R. L., A. Howes, and S. Singh. “Computational rationality: Linking mechanism and behavior through bounded utility maximization.” Topics in Cognitive Science, 2014. doi:10.1111/tops.12086
- Simon, H. A. “A behavioral model of rational choice.” Quarterly Journal of Economics, 1955. doi:10.2307/1884852
- Hoffmann, J., et al. “Training compute-optimal large language models.” NeurIPS, 2022. arXiv:2203.15556
- Savage, L. J. The Foundations of Statistics. Wiley, 1954.
- Magnac, T., and D. Thesmar. “Identifying dynamic discrete choice processes.” Econometrica, 2002. doi:10.1111/1468-0262.00306
- Ng, A. Y., and S. Russell. “Algorithms for inverse reinforcement learning.” ICML, 2000.
- Ernst, M. O., and M. S. Banks. “Humans integrate visual and haptic information in a statistically optimal fashion.” Nature, 2002. doi:10.1038/415429a
- Duffy, S., J. Hertel, D. Igan, M. Pinheiro, and J. Smith. “On Bayesian integration in sensorimotor learning: Another look at Kording and Wolpert (2004).” Cortex, 2022. doi:10.1016/j.cortex.2022.03.021
- Jonas, E., and K. P. Kording. “Could a neuroscientist understand a microprocessor?” PLoS Computational Biology, 2017. doi:10.1371/journal.pcbi.1005268
- Plaut, D. C. “Double dissociation without modularity: Evidence from connectionist neuropsychology.” Journal of Clinical and Experimental Neuropsychology, 1995. doi:10.1080/01688639508405124
- Olah, C., N. Cammarata, L. Schubert, G. Goh, M. Petrov, and S. Carter. “Zoom in: An introduction to circuits.” Distill, 2020. doi:10.23915/distill.00024.001
- Rajaram, A., N. Chowdhury, A. Torralba, J. Andreas, and S. Schwettmann. “Automatic discovery of visual circuits.” arXiv, 2024. arXiv:2404.14349
- Olsson, C., et al. “In-context learning and induction heads.” Transformer Circuits Thread, 2022. Link
- Richards, B. A., et al. “A deep learning framework for neuroscience.” Nature Neuroscience, 2019. doi:10.1038/s41593-019-0520-2
- Marr, D. “Artificial intelligence: A personal view.” Artificial Intelligence, 1977. doi:10.1016/0004-3702(77)90013-3
- Lillicrap, T. P., and K. P. Kording. “What does it mean to understand a neural network?” arXiv, 2019. arXiv:1907.06374
- Tenenbaum, J. B., C. Kemp, T. L. Griffiths, and N. D. Goodman. “How to grow a mind: Statistics, structure, and abstraction.” Science, 2011. doi:10.1126/science.1192788
- McCoy, R. T., S. Yao, D. Friedman, M. D. Hardy, and T. L. Griffiths. “Embers of autoregression show how large language models are shaped by the problem they are trained to solve.” Proceedings of the National Academy of Sciences, 2024. doi:10.1073/pnas.2322420121
- Yamins, D. L. K., H. Hong, C. F. Cadieu, E. A. Solomon, D. Seibert, and J. J. DiCarlo. “Performance-optimized hierarchical models predict neural responses in higher visual cortex.” Proceedings of the National Academy of Sciences, 2014. doi:10.1073/pnas.1403112111
- Ortega, P. A., et al. “Meta-learning of sequential strategies.” arXiv, 2019. arXiv:1905.03030
- Binz, M., et al. “Meta-learned models of cognition.” Behavioral and Brain Sciences, 2024. doi:10.1017/S0140525X23003266
- Xie, S. M., A. Raghunathan, P. Liang, and T. Ma. “An explanation of in-context learning as implicit Bayesian inference.” ICLR, 2022. arXiv:2111.02080
- Garg, S., D. Tsipras, P. Liang, and G. Valiant. “What can transformers learn in-context? A case study of simple function classes.” NeurIPS, 2022. arXiv:2208.01066
- Raventós, A., M. Paul, F. Chen, and S. Ganguli. “Pretraining task diversity and the emergence of non-Bayesian in-context learning for regression.” NeurIPS, 2023. arXiv:2306.15063
- Wurgaft, D., E. S. Lubana, C. F. Park, H. Tanaka, G. Reddy, and N. D. Goodman. “In-context learning strategies emerge rationally.” NeurIPS, 2025. arXiv:2506.17859
- Skalse, J., M. Farrugia-Roberts, S. Russell, A. Abate, and A. Gleave. “Invariance in policy optimisation and partial identifiability in reward learning.” ICML, 2023. arXiv:2203.07475
- Vafa, K., P. G. Chang, A. Rambachan, and S. Mullainathan. “What has a foundation model found? Using inductive bias to probe for world models.” ICML, 2025. arXiv:2507.06952
- Li, K., A. K. Hopkins, D. Bau, F. Viégas, H. Pfister, and M. Wattenberg. “Emergent world representations: Exploring a sequence model trained on a synthetic task.” ICLR, 2023. arXiv:2210.13382
- Zhou, X., Y. Xu, G. Tie, Y. Chen, G. Zhang, D. Chu, P. Zhou, and L. Sun. “LIBERO-PRO: Towards robust and fair evaluation of vision-language-action models beyond memorization.” arXiv, 2025. arXiv:2510.03827
- Sutton, R. S. “The bitter lesson.” Incomplete Ideas, 2019. Link
- Ashby, W. R. Design for a Brain. Chapman & Hall, 1952.
- Kemp, C., A. Perfors, and J. B. Tenenbaum. “Learning overhypotheses with hierarchical Bayesian models.” Developmental Science, 2007. doi:10.1111/j.1467-7687.2007.00585.x
- Wang, J. X., et al. “Prefrontal cortex as a meta-reinforcement learning system.” Nature Neuroscience, 2018. doi:10.1038/s41593-018-0147-8
- Simon, H. A. “The architecture of complexity.” Proceedings of the American Philosophical Society, 1962. JSTOR
- Goodman, N. D., T. D. Ullman, and J. B. Tenenbaum. “Learning a theory of causality.” Psychological Review, 2011. doi:10.1037/a0021336
- Ma, Y. J., et al. “Eureka: Human-level reward design via coding large language models.” ICLR, 2024. arXiv:2310.12931
- Paterson, J. R., D. C. García-Bellido, M. S. Y. Lee, G. A. Brock, J. B. Jago, and G. D. Edgecombe. “Acute vision in the giant Cambrian predator Anomalocaris and the origin of compound eyes.” Nature, 2011. doi:10.1038/nature10689
- Bicknell, R. D. C., M. Schmidt, I. A. Rahman, G. D. Edgecombe, S. Gutarra, A. C. Daley, R. R. Melzer, S. Wroe, and J. R. Paterson. “Raptorial appendages of the Cambrian apex predator Anomalocaris canadensis are built for soft prey and speed.” Proceedings of the Royal Society B, 2023. doi:10.1098/rspb.2023.0638
- Van Roy, P., A. C. Daley, and D. E. G. Briggs. “Anomalocaridid trunk limb homology revealed by a giant filter-feeder with paired flaps.” Nature, 2015. doi:10.1038/nature14256
- Potin, G. J.-M., P. Gueriau, and A. C. Daley. “Radiodont frontal appendages from the Fezouata Biota (Morocco) reveal high diversity and ecological adaptations to suspension-feeding during the Early Ordovician.” Frontiers in Ecology and Evolution, 2023. doi:10.3389/fevo.2023.1214109
- Menon, A., S. Machcha, S. Zou, T. K. Chan, and J. Chooi. “GPT-6 Astra on robotic manipulation.” Robocurve, September 4, 2026. Link
- Zhang, W., et al. “An unexpected robot policy: Early evaluations of GPT-6 Astra on RoboDojo and beyond.” arXiv, 2026. arXiv:2609.24170
- Shumailov, I., et al. “AI models collapse when trained on recursively generated data.” Nature, 2024. doi:10.1038/s41586-024-07566-y
- Odling-Smee, F. J., K. N. Laland, and M. W. Feldman. Niche Construction: The Neglected Process in Evolution. Princeton University Press, 2003.
- Smith, J. E., and R. L. Winkler. “The optimizer’s curse: Skepticism and postdecision surprise in decision analysis.” Management Science, 2006. doi:10.1287/mnsc.1050.0451
- Dwork, C., V. Feldman, M. Hardt, T. Pitassi, O. Reingold, and A. Roth. “The reusable holdout: Preserving validity in adaptive data analysis.” Science, 2015. doi:10.1126/science.aaa9375